Claude Fable 5.2登場 2割値下げ、費用はeffortの設定で大きく変わる

日本時間11月10日の未明、Anthropicが「Claude Fable 5.2とClaude Mythos 5.2」を発表しました。9月のFable 5.1から約2か月での更新です。
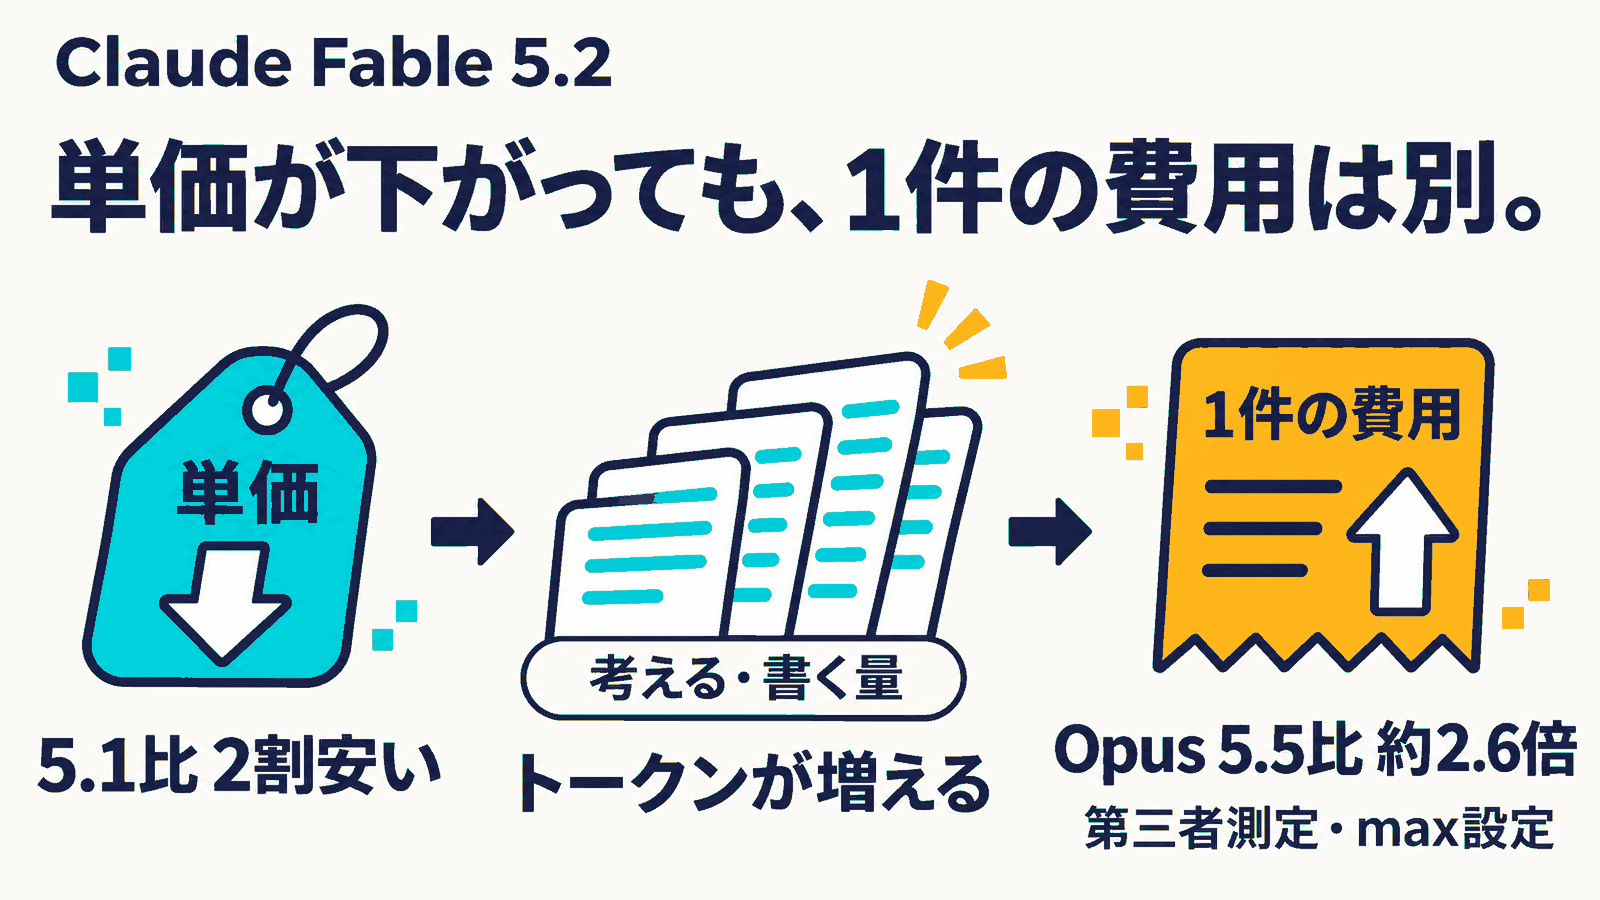
見出しになりやすいのは、料金が2割下がったことと、性能の数字です。第三者の評価でも、総合点で1位になりました。ただ、同じ第三者の測定では、いちばん高い設定で回したときの作業1件あたりの費用は、5.1の約2倍、Opus 5.5の約2.6倍でした。一方で、設定をhighまで下げると、Opus 5.5の最高の設定より高い点数を、より安く出しています。単価が下がったかどうかより、どの設定で使うかのほうが、請求には大きく響くモデルです。
Fable 5.2は、Opus 5.5の一段上に置かれた「難しい仕事用」のモデル
Fable 5.2とMythos 5.2は、中身が同じモデルです。違いは安全装置で、Fableにはサイバーセキュリティと生物学の分野で悪用を防ぐ仕組みが入っていて、有料プランなら誰でも使えます。Mythosはその制限を緩めた版で、サイバー防御や生命科学の研究をする組織が、審査を通ったうえで使えます。この関係は、5.1のときと変わりません。
公式の発表で目を引くのは、使い分けの勧め方です。ほとんどのコーディングや知識作業は、まずOpus 5.5から始め、範囲や難しさに応じて上のFableか、下のSonnet 5.5やHaiku 5.5に切り替える。Fableは、先が見えにくい、いちばん難しい技術的な仕事向けだとしています。小さいモデルが行き詰まったときに相談する役(Advisor)や、簡単な仕事を小さいモデルに振り分ける役(Orchestrator)としても使える、とも書かれています。
料金は5.1より2割安く、出力は最大3割速い。fast modeは倍の料金で2.5倍速い
料金ページの100万トークンあたりの単価を、近いモデルと並べるとこうなります。
| モデル | 入力 | 出力 | キャッシュの読み出し |
|---|---|---|---|
| Fable 5.2 | 8ドル | 40ドル | 0.20ドル |
| Fable 5.1 | 10ドル | 50ドル | 0.25ドル |
| Opus 5.5 | 4ドル | 20ドル | 0.20ドル |
| Sonnet 5.5 | 2ドル | 10ドル | 0.10ドル |
5.1と比べると、入力・出力・キャッシュの読み出しのどれも2割安くなりました。キャッシュの読み出し(一度読み込んだ内容を、次に同じものを参照するときの料金)は、Opus 5.5と同じ0.20ドルです。長い会話を何度も読み直す使い方では、この料金も積み上がっていきます。
出力の速さは、5.1より最大30%速くなったとしています。新しく用意されたfast modeは、料金が倍(入力16ドル・出力80ドル)になるかわりに、出力の速さが最大2.5倍になります。Claude CodeやClaude Platformなどで使えます。
Proは11月17日まで枠内、Max・Ultraには使った分を戻すリセットが付く
プラン別のヘルプによると、Fable 5.2の扱いは5.1と同じで、契約によって支払い方が分かれます。ただし今週は、発売記念の特典が上乗せされています。
| 契約 | ふだんの扱い | 発売記念の特典 |
|---|---|---|
| Pro、Teamの標準シート | プランの枠に含まれず、追加課金(使用量クレジット) | 米国時間11月16日の終わり(日本時間17日16時59分)まで、週の上限の50%まで枠内で使える。条件を満たせばリセット1回 |
| Max、Ultra、Teamのプレミアムシートなど | 週の上限の50%まで枠内で使える | 条件を満たせば、契約期間に応じてリセット1〜3回(6か月未満1回、6〜12か月2回、12か月超3回)。期限は日本時間2027年3月9日15時59分 |
| API、従量課金のEnterprise | API料金 | なし |
Proの「1週間の枠内利用」は対象のプランならそのまま使えますが、リセットがもらえるのは、日本時間11月10日午前3時(米国時間9日午前10時)より前に有料の契約があった人だけです。TeamやEnterpriseでは、それまでに組織に参加していることも条件です。発表を見てから契約した人には付きません。
リセットは、Fableに使った分の週の使用量を、使う前の状態に戻すものです。上限が増えるわけではなく、ほかのモデルに使った分は戻りません。5時間の枠があるプランでは、その枠も丸ごと戻ります。「設定」の「使用状況」から、好きなときに使えます。
Claude Codeで使うには、バージョン2.1.321以降が必要です。Enterpriseでは、管理者が有効にするまでは使えず、発売から7日後に、Fableを許可しているロールへ自動で追加されます。
性能は第三者の評価でも首位。費用は設定しだいでOpus 5.5より安くも高くもなる
公式の発表には、Opus 5.5、GPT-6 Astra、Gemini 4 Carbonと並べた表があります。いくつか抜き出すと、こうなります(Anthropicが自分で測った数字です。原則として各モデルの最高の設定での結果で、FrontierCode 2.0だけはFable 5.2と5.1がxhigh、Gemini 4 Carbonがmediumの結果です)。
| テスト | Fable 5.2 | Fable 5.1 | Opus 5.5 | GPT-6 Astra | Gemini 4 Carbon |
|---|---|---|---|---|---|
| コーディング(FrontierCode 2.0) | 49.1% | 32.4% | 45.5% | 42.8% | 41.1% |
| 業務の自動化(AutomationBench) | 51.4% | 31.4% | 42.5% | 41.4% | 53.9% |
| パソコン操作(OSWorld 2.1) | 89.3% | 83.5% | 87.2% | 79.5% | 81.5% |
| 専門知識と推論(Humanity's Last Exam、ツールあり) | 74.2% | 65.6% | 67.7% | 57.2% | — |
ほとんどの項目で首位ですが、業務の自動化ではGemini 4 Carbonが上回っています。公式は、設定をhighにすると、Opus 5.5の最高の設定とほぼ同じ点数(45.3%対45.5%)を、作業1件あたり約半分の費用で出せる、とも書いています。
第三者の測定も出ています。AIモデルを独自に評価しているArtificial Analysisの総合指標では、Fable 5.2(max)が65点で1位でした。同じサイトの各モデルのページから、総合点と、テスト1件あたりにかかった費用と時間を並べます(11月10日時点)。
| モデル(設定) | 総合点 | 1件あたりの費用 | 1件あたりの時間 |
|---|---|---|---|
| Fable 5.2(max) | 65 | 26.54ドル | 44.1分 |
| Gemini 4 Carbon(high) | 60 | 7.76ドル | 27.2分 |
| Opus 5.5(max) | 59 | 10.04ドル | 25.1分 |
| GPT-6 Astra(max) | 57 | 6.24ドル | 22.6分 |
| GPT-6.1 Sol(max) | 55 | 1.27ドル | 20.2分 |
| Fable 5.1(max) | 49 | 12.99ドル | 22.7分 |
いちばん高い設定(max)どうしで比べると、単価は5.1より2割安いのに、1件あたりの費用は5.1の約2倍、Opus 5.5の約2.6倍です。一因は、出すトークンの量です。Artificial Analysisによると、総合指標のテストを回すのにFable 5.2(max)が出したトークンは2億7,500万で、Fable 5.1の1億6,300万の約1.7倍でした(費用には、出力のほか入力やキャッシュの料金も含まれます)。Xでも、単価は下がったのに作業ごとの費用は倍近くになった、という指摘が出ていました。
ただ、話はここで終わりません。同じサイトのランキングには、推論の深さの設定(effort)ごとの結果も載っています。Fable 5.2とOpus 5.5を設定ごとに並べると、こうなります。
| 設定 | Fable 5.2 | Opus 5.5 |
|---|---|---|
| max | 65点 / 26.54ドル | 59点 / 10.04ドル |
| xhigh | 62点 / 14.83ドル | 57点 / 6.05ドル |
| high | 62点 / 9.08ドル | 52点 / 3.46ドル |
| medium | 56点 / 3.80ドル | 48点 / 2.45ドル |
| low | 54点 / 3.10ドル | 35点 / 0.98ドル |
同じ設定どうしなら、Fable 5.2のほうが点数は高く、費用も高くなります。一方で、Fable 5.2のhighは、Opus 5.5のmaxより3点高く、1件あたりの費用は1ドルほど安い。Fable 5.2のlowも、Opus 5.5のhighより2点高く、費用は少し安くなっています。公式が書いていた「Fableのhighなら、Opusの最高の設定とほぼ同じ点数を約半分の費用で」という話とも、方向は合います。
Fable 5.2が高いか安いかは、どの設定どうしを比べるかで変わる、というのが筆者の読みです。
当社のClaude Codeで比べると、結果は同じで、費用は約1.8倍だった
11月10日の朝、私たちのClaude Codeで、Opus 5.5とFable 5.2に同じ作業を頼んでみました。題材は、このブログの143本の記事です。執筆ルールのうち機械で確かめられるもの(タイトルや説明文の字数、h2の本数、結びの見出しが「最後に」で始まるか、太字の崩れ、使わないと決めている言い回しなど)を全記事について点検するスクリプトを書かせ、実行して、結果を報告書にまとめる、という依頼です。依頼文も、記事のコピーも、許可した操作も同じにして、2つを同時に走らせました。推論の設定は、Claude Codeの初期設定(medium)のままです。
| Opus 5.5 | Fable 5.2 | |
|---|---|---|
| 終わるまで | 2分49秒 | 3分2秒 |
| やり取りの回数 | 25回 | 20回 |
| 出力したトークン(うち考えた分) | 約1万5,200(約3,100) | 約1万7,900(約5,400) |
| 費用(API料金での概算) | 約1.07ドル | 約1.89ドル |
費用は、Claude Codeが表示するAPI料金での概算です。私たちのようにサブスクで使う場合は、お金ではなく週の利用枠が減りますが、枠がどれだけ減ったかは今回は測っていません。Fable 5.2は、やり取りの回数は少ないのに、考える量と書く量が多く、費用はOpus 5.5の約1.8倍でした。単価が倍なので、トークンの量がほぼ同じでも費用はほぼ倍になります。
結果のほうは、字数、h2の本数、結びの見出し、ダッシュ、太字の6項目で、2つの件数がぴったり一致しました。私たちが別に書いた点検の結果とも照らし合わせ、どちらも正しいことを確かめています(h2の数え方は、こちらがコードブロックの中まで数えていて、2つのモデルのほうが正しいくらいでした)。太字の点検では、2つとも「ルールに書かれた判定方法だと17件引っかかるが、表示が実際に崩れるのは1件だけ」と、ルール側の判定の甘さまで指摘してきました。その1件は、公開中の記事で実際に太字の範囲がずれていたので、別に直します。
違いが出たのは、判断が要る「使わない言い回し」の項目です。Opus 5.5は62件を挙げ、本来の意味なら使ってよい語を候補として8件だけ別にしました。Fable 5.2は、文字列として見つかったもの106件と、文脈を見て判断する候補158件に分け、内訳まで添えてきました。件数の差は、主に探し方の違いです。Opus 5.5が「しておきます」で探して11件だったのに対し、Fable 5.2は「〜ておきます」まで広げて55件を拾っていて、ほかの言い回しの件数は同じでした。報告書の整理はFable 5.2のほうが丁寧でしたが、候補の大半は「効く」のように本来の意味で使っている語で、実際に目を通してみると、確かめる手間はかえって増えた、というのが正直な感想です。多く拾うことと、正しく絞ることは別の力です。
1回の比較なので、これで実力を言い切ることはできません。それでも、答えがはっきり決まる作業では、Fable 5.2に頼んでも結果は変わらず、費用だけが約1.8倍になりました。公式が「まずOpus 5.5から」と勧めているのも、うなずけます。
コーディング中のブロックは55%減。Mythosとデータの保持は従来どおり
Fableには、サイバー攻撃や生物学の危険な研究に使われないよう、質問を止める安全装置が入っています。5.1までは、ふつうのコーディング中に止められる、という不満が出ていました。公式によると、Fable 5.2では不要なブロックが5.1より約55%減りました(サイバー分野で約60%、生物分野で約40%)。止められた質問には、サイバー分野ならOpus 4.8、生物分野ならOpus 5が代わりに答えます。
制限の緩いMythos 5.2は、引き続き審査制です。サイバーセキュリティの専門家はCyber Verification Program、生命科学の研究者はLife Sciences Verification Programから申し込みます。Claude Enterpriseの契約者は、Mythos 5.2も使ってコードの脆弱性を探す「Claude Security」を使えます。
データの扱いも変わっていません。Fableのような強いモデルは、複数のやり取りをまたいで悪用を見張るため、通常は入力と出力が少なくとも30日保持され、安全面の調査などがあればさらに長くなることがあります。データを自社のクラウドに置いたまま監視できる「Enterprise Frontier Safeguards」は、限定ベータとして提供が始まりました。この仕組みの背景は、ZDR(ゼロデータ保持)の記事で詳しく書いています。
最後に、モデルの名前より「設定」まで含めて比べる。Proなら今週のうちに試す
ここから先は筆者の考えです。答えがはっきり決まる作業や、毎日の細かい依頼は、これまでどおりOpus 5.5で十分だと思います。
一方で、Opus 5.5を最高の設定で回しているような重い仕事なら、Fable 5.2のhighが比べる候補になります。第三者の総合評価では、そちらのほうが点数は高く、費用は安くなっていました。ただ、自分の仕事でも同じになるとは限らないので、同じ依頼を両方に頼み、どの設定で使ったかも一緒に記録しておくのがよいと思います。
Proの人には、今週がちょうどいい機会です。日本時間11月17日の夕方までは、週の上限の半分まで追加料金なしでFable 5.2を使えます。ふだんOpus 5.5で手こずっている仕事を1つ選び、Fable 5.2にも同じように頼んでみてください。見比べるのは、仕上がりだけでなく、見落としの数、人が手直しにかけた時間、利用枠の減り方です。この3つを並べると、自分の仕事でFableに追加料金を払う価値があるかが見えてくると思います。