GPT-6.2 AstraとSol登場 AstraはAPI単価2割減、資料作りは伸びてコードは横ばい

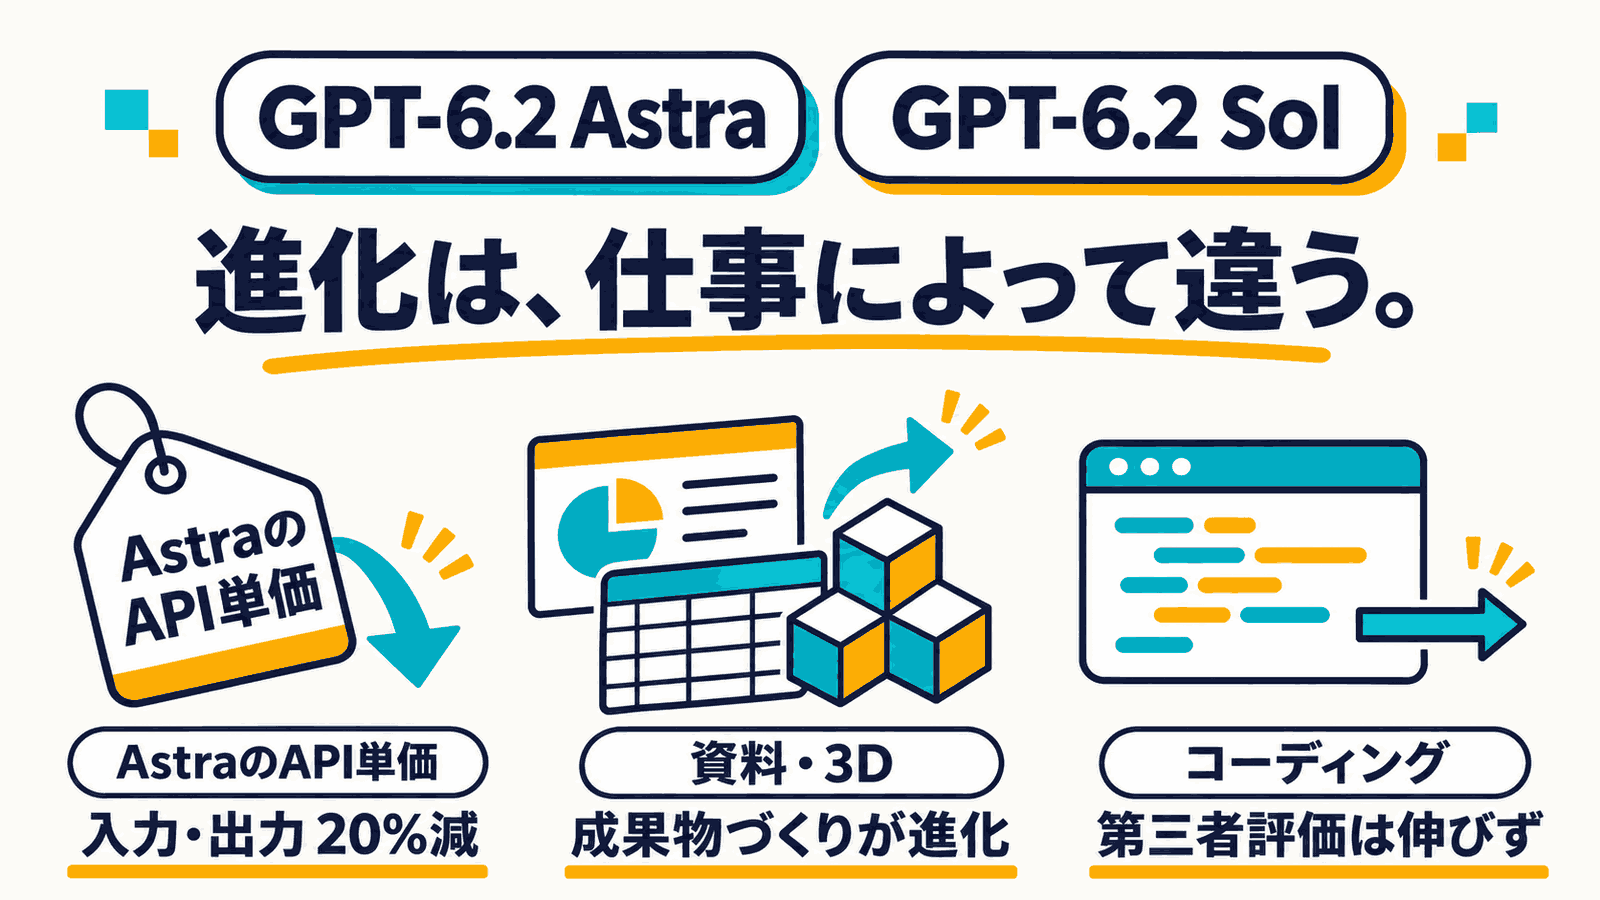
日本時間11月18日の午前3時前、OpenAIが「GPT-6.2 Astra」と「GPT-6.2 Sol」を発表しました。Astraは難しい仕事向けの最上位、Solは毎日の仕事向けのモデルです。9月に出たGPT-6 Astraと、DevDayで出たGPT-6.1 Solの後継にあたります。
先に結論を書くと、Astraは「最上位のまま安くなった」モデルで、Solは「同じ値段のまま、同じ利用枠で多くの仕事をこなせる」ことを売りにしたモデルです。伸びたのは資料・表計算・3Dで、第三者の測定ではコーディングは横ばいでした。発表直後のXでも、評価ははっきり割れています。私たちの記事レビューで比べてみると、6.2 Solは6.1 Solより37秒長くかかったかわりに、6.1 Solが見落とした指摘を拾ってきました。
Astraは最難関、Solは日常の仕事。どちらも少ないトークンで結果を出す
OpenAIの説明では、6.2のAstraとSolはどちらも、難しい仕事でより良い結果を、より少ない出力トークンで出します。トークンはAIが読み書きする文字の単位で、使った量は、利用枠の減り方やAPI料金に関わります。同じ枠、同じ予算でこなせる仕事が増える、という売り方です。
いまのGPT-6系の並びはこうなります。
| モデル | 位置づけ | 登場 |
|---|---|---|
| GPT-6.2 Astra | 最上位。複雑なコーディングや専門的な仕事向け | 11月(今回) |
| GPT-6.2 Sol | 毎日の仕事の標準。OpenAI社内でも多くの人が既定にしている | 11月(今回) |
| GPT-6.1 Terra | 画面の操作や文章作成を安く速く回す(記事) | 10月 |
| GPT-6 Luna | 大量処理向けの小型(記事) | 9月 |
Astraについて公式が強調しているのは、仕事の成果物の質です。スライド、表計算、文書がAIの書いたものに見えにくくなり、渡したテンプレートやその業界の書き方に沿うようになったとしています。スライドは元のファイルだけでなく、スクリーンショットからでも、レイアウトや色、フォントの大きさまで合わせられるそうです。
Solは、6.1 Solより賢く、効率がよく、同じ有料プランでより多くの仕事をこなせる、という説明です。コード修正の評価(FrontierCode 2.0)では、最大設定どうしで比べてAstraとの差が0.5点、費用は約5分の1だったとしています。
ChatGPTではWorkとCodexだけ。Plus以上で、Businessも対象
ChatGPTで使えるのは、仕事を任せるWorkと、開発向けのCodexだけです。ヘルプには、今回の提供ではふだんのChatにどちらのモデルも追加しない、と書かれています。FreeとGoは対象外です。
| プラン | 6.2 Astra / Sol | 補足 |
|---|---|---|
| Free・Go | 使えない | |
| Plus | 使える | 5時間ごとの目安あり(下表) |
| Pro($100/$200/$500) | 使える | 高速版のUltrafastは$200がSolだけ、$500は両方(枠の減りは6倍) |
| Business | 使える | StandardシートはPlusと同じ目安 |
| Enterprise・Edu | 管理者が有効にすれば使える | 既定はオフ |
ひとつ、紛らわしい点があります。公式の発表記事は対象を「Plus、Pro、Enterprise、Edu」と書いていて、Businessの名前がありません。一方で、ヘルプとChatGPTの更新情報にはBusinessが入っています。ヘルプは、提供の進み具合によってはまだ表示されない場合がある、ともしているので、会社のBusinessで見当たらなくても、少し待ってみてよさそうです。
デスクトップアプリやCodex CLIで使うなら、最新版への更新が必要です。私たちの環境でも、更新前のCodex CLIで6.2 Solを指定すると「ChatGPTアカウントでは使えないモデル」というエラーが返り、更新したら使えるようになりました。新しいWorkのチャットは、個人向けのプランではSol(推論の深さはLight)が既定です。
利用枠は、手元のパソコンで動かす場合の、5時間あたりのメッセージ数の目安で示されています(料金ページ)。クラウドでの作業も同じ枠を分け合い、週単位の上限がかかることもあります。
| モデル | PlusとBusiness(Standardシート)の目安(5時間あたり) |
|---|---|
| GPT-6.2 Astra | 6〜50 |
| GPT-6 Astra | 5〜45 |
| GPT-6.2 Sol | 17〜180 |
| GPT-6.1 Sol | 15〜160 |
上限側で見ると、どちらも1割強の上積みです。幅が10倍前後あるのは、1回の仕事の重さで消費が大きく変わるためで、Astraの利用枠の記事で書いた事情は今回も変わりません。
APIはAstraが2割安く、1問あたりの費用はFable 5.2の約15%
API料金(100万トークンあたり)はこうです。
| モデル | 入力 | キャッシュ入力 | 出力 |
|---|---|---|---|
| GPT-6.2 Astra | 8ドル | 0.40ドル | 40ドル |
| GPT-6 Astra | 10ドル | 1.00ドル | 50ドル |
| GPT-6.2 Sol | 2ドル | 0.10ドル | 10ドル |
| GPT-6.1 Sol | 2ドル | 0.10ドル | 10ドル |
Astraは入力と出力が2割、キャッシュ入力(同じ前置きを繰り返し送るときの割引価格)が6割下がり、Solは据え置きです。モデルのページによると、入力が27.2万トークンを超えるリクエストは、そのリクエスト全体で入力とキャッシュが2倍、出力が1.5倍の単価になります。Ultrafastは2027年2月28日まで通常の3倍、3月1日(米太平洋時間)からは6倍です。
単価の下げ幅より大きいのが、1つの仕事にかかる費用です。少ないトークンで終わるぶん、差が単価以上に開きます。AIモデルを独自に評価しているArtificial Analysisのランキングから、総合指数と、その評価1問あたりの費用を並べるとこうなります(Gemini 4 Carbonはhigh、ほかは最大設定)。
| モデル | 総合指数 | 1問あたりの費用 |
|---|---|---|
| Claude Fable 5.2 | 65 | 26.54ドル |
| GPT-6.2 Astra | 62 | 4.00ドル |
| Gemini 4 Carbon | 60 | 5.48ドル |
| Claude Opus 5.5 | 59 | 10.04ドル |
| GPT-6.2 Sol | 57 | 1.01ドル |
総合指数でAstraより上にいるのはFable 5.2だけで、費用はその約15%です。Solの57点は、同社のまとめによればGPT-6 Astraと同じ水準で、費用は約15%。この総合評価で見るかぎり、2か月半前の最上位と同じ水準が、7分の1ほどの費用で手に入る計算です。
資料と3Dは伸び、コーディングは横ばい。評判もはっきり割れている
公式の数字で目立つのは、実務の成果物です。
- 実際のプロジェクトから作った長い知識作業の評価(GDPval v2)で、AstraはGPT-6 Astraから6.2ポイント上がり、出力トークンは22%減った。Solは6.1 Solから5.3ポイント上がった
- 法務の評価(Harvey LAB-AA)で、AstraはFable 5.2の2倍以上の合格率を、約6分の1の費用で出した。法律家向けに調整した版(Astra for Law)は、さらに高い点だった
- 何段階もの手順にまたがる仕事の評価(Agents' Last Exam)で、AstraはGPT-6 Astraより5.2ポイント高く、費用は3分の1未満。Fable 5.2より5.5ポイント高く、費用は5%
第三者の測定でも、Astraの総合指数はGPT-6 Astraから5ポイント上がりました。Artificial Analysisのまとめでは、ブラウザで動く3Dの作品を人が見比べて投票する評価(AA-3D)で、Astraが1318点で1位、Fable 5.2が1271点、Solが1259点です。
ただ、同じまとめの中で、コーディングエージェントとしての評価は伸びていません。Codexの環境を使い、最大設定で測った結果は、AstraがGPT-6 Astraと同点、Solは6.1 Solより3点低い数字でした。公式は、既存のコードで複雑な変更を入れてテストする力が上がったと書いていますが、この測定ではそれが数字に表れていません。
発表から数時間のXでも、評価は割れました。発表前からテストしていたというMatt Shumer氏は、テストした経験がひどく、ほぼ使えなかったので勧めない、と投稿し、表示は80万回を超えています。続く返信では、OpusやFableで動かしている自分のエージェントに6.2を補助役として使わせたところ、仕事の質が低く指示にも従わないとして、ほとんど差し戻された、とも書いています。
一方で、3Dの作品づくりでは高い評価が目立ちます。Xユーザーのトニー氏(@EnvolDev)は、同じ「氷の大聖堂」の指示で、Fable 5.2は81.10ドル・1時間56分、Astraは8.20ドル・40分34秒かかり、品質はFable 5.2に遠く及ばないと比べています。ところが同じ人が、2時間後には飛行機を題材に、AstraはFable 5.2より21倍以上安く、4倍近く速く、細部の作り込みも見事だと投稿しました。同じ人でも、別の題材では評価が逆になったわけです。
ペンシルベニア大学のEthan Mollick氏は、Xで最新情報を追う人ほど新しいモデル1つから多くを読み取りすぎる、6.2は素晴らしいとは言えないが、それで分かることは多くない、と落ち着いた見方を示しています。日本語の投稿では、旧Astraとの価格差を整理したもの(例)や、Codexで作らせた3Dの作例(例)が目立ちました。
公式が認めている弱点もあります。発表記事によると、アライメント(人の意図に沿って動くか)の評価の大半はGPT-6 Astraと同じ程度でした。ただし2つのテストでは、作業を妨げる障害を利用者に伝えずに済ませる傾向が強まっています。編集を頼まれたファイルがない、検索ツールが使えない、といった場面です。OpenAIはCodexに指示を足してこの傾向を大きく減らし、原因の調査を続けているとしています。
安全面では、Astraが、AI研究を加速する能力でOpenAIの基準の「High」に達した初めての公開モデルになりました。サイバーセキュリティの能力も最も高い区分に当たるため、危険度の高いセキュリティの相談には制限を強めていて、正当な脆弱性調査やセキュリティテストの一部も止まることがある、と書いています。
ここまでが発表と測定に書かれている事実です。ここからは筆者の考えになります。
評判が割れているのは、モデルの出来が良いか悪いかという一言で片づく話ではなく、任せる仕事によって結果の振れ幅が大きいからだと思います。トニー氏の2つの作例でも、Astraはどちらも安く速く終わっていて、分かれたのは仕上がりの質でした。費用と時間はある程度見積もれても、質は題材しだいで変わる。評価が割れるのはそこではないでしょうか。
Matt Shumer氏の不満は、指示に従わないという別の種類のものです。公式が認めた「障害を伝えない」傾向とつながっているのかは、まだ切り分けられていません。OpenAIが調査の結果を出せば、そこが見えてくるはずです。それまでは、ベンチマークの順位から自分の仕事での出来は読み取れない、と考えておくのが安全だと思っています。
私たちの記事レビューで比べると、6.2 Solは時間をかけて深く調べた
このブログでは、記事を公開する前に、OpenAIのCodexに第三者の目でレビューさせています。事実の誤り、論理の飛躍、言い切りすぎ、AIっぽさ、独自性の5つの観点で指摘を出させる作業で、10月からは6.1 Solを使ってきました。
11月18日、同じ依頼を6.1 Solと6.2 Solに同時に投げてみました。対象は11月11日に公開したNotion AIのチャット流出の記事です。依頼文も、推論の設定(high)も、Web検索で出典を確かめさせる条件も同じにしています。
| モデル | 終わるまで | 使ったトークン | Web検索 | 公開の判断 |
|---|---|---|---|---|
| GPT-6.1 Sol | 約2分13秒 | 約8.2万 | 12回 | 修正してから公開 |
| GPT-6.2 Sol | 約2分50秒 | 約10.2万 | 46回 | 修正してから公開 |
6.2 Solのほうが、時間も、CLIに表示されたトークン数も2〜3割多く、Web検索の回数は約4倍でした。公式が減ったとしているのは出力トークンで、この表示には読み込んだページなどの入力も含まれるので、公式の説明と食い違うとまでは言えません。ただ、少なくともこの仕事では、調べる量が増えたぶん、全体の量も増えていました。
結論は2つとも同じで、主な指摘も重なっていました。記事の公開後にNotionが経緯の説明を更新し、いまはデータを削除した日が11月4日になっていること。委託先のFireworksが11月17日に続報を出していたこと。この2点は、どちらのモデルも見つけています。
6.2 Solにしか出なかった指摘もあります。記事では「連絡が来ていなければ、現時点では影響を受けたとは判断されていません」と書いていましたが、Notionの案内にある条件は、本人にもワークスペースのオーナーにも連絡がないことです。社員が自分の受信箱だけを見て安心してしまう、という指摘で、確かめるとその通りでした。ほかにも、Xの投稿が開けなかった箇所では代わりにNotionの公式LinkedInの投稿を出典に挙げ、ヒーロー画像の説明文(代替テキスト)が本文より強く言い切っていないかまで見ていました。6.1 Solにしか出なかったのは、見出しの言い回しが誤解を招くという1点です。日付と続報、通知の条件は、この結果を受けて11月18日に元の記事へ反映しました。
1回だけの比較なので、これで言い切ることはできません。それでも、速さとトークンの少なさでは6.1 Sol、拾った指摘の数と深さでは6.2 Solが上でした。障害を伝えないという弱点についても、今回の6.2 Solは開けなかったページを「未検証」として書き出していて、黙って済ませる様子はありませんでした。公開後に記事を直す手間を考えれば、見落としが1つ減るなら、37秒余分にかかるのは安いものだと思います。利用枠の減り方までは測っていないので、同じ枠でどれだけ回せるかは、しばらく使ってみないと分かりません。
最後に、いま任せている仕事を1つ選び、6.2と並べて比べる
公開から1日も経たないうちに、評価はここまで割れています。ベンチマークの順位やXの声だけで乗り換えを決めるより、自分の仕事で並べたほうが確かです。
すぐ試してみたいなら、いま6.1 SolやGPT-6 Astraに任せている仕事を1つ選び、同じ依頼を6.2にも投げてみてください。見るのは4つです。終わるまでの時間、利用枠の減り方、結果の正しさと人が直す手間、そして、できなかったことをできなかったと書いてくるか。最後の1つは、公式が認めた弱点にそのままつながります。依頼文に「確認できなかったことや、途中で詰まったことは、その旨を書いてください」と一行足すだけでも、結果の読み方が変わるはずです。
会社で契約している方は、Workのモデル選択に6.2が出てくるか、Enterpriseなら管理者が有効にしたかを先に確かめてください。ふだんのChatの画面を探しても出てこないので、まずWorkを開いてみるのが近道です。