GPT-6.1 Terra登場 画面操作はAstra並み、単価は10分の1

日本時間10月27日の未明、OpenAIが「GPT-6.1 Terra」を発表しました。最上位のGPT-6 Astraでも、軽量のLunaでもない、その間に入るモデルです。画面に映っている内容を読み取ってアプリを操作したり、自然な文章を書いたりといった、ふだんの仕事を速く安く回すことに寄せています。
公式の言い分を一言でまとめると、「画面を操作する仕事のテストでは、Astraとほぼ同じ点数を、トークン単価10分の1で出す」です。本当にそこまで使えるのか。公式の発表とヘルプで確かめた内容に、私たちが自分たちの作業で比べた結果を足してまとめます。
Terraは、画面を見て操作する仕事を安く速く回すためのモデル
ChatGPTのWorkとCodexで勧められている主なモデルは、4つの名前で役割が分かれています。モデルの説明をもとに並べると、こうなります。
| モデル | 公式の位置づけ |
|---|---|
| GPT-6 Astra | いちばん負荷の高い仕事向け |
| GPT-6.1 Sol | Astraに迫る性能を、Astraより安く |
| GPT-6.1 Terra | 文章、画像の読み取り、画面の操作を速く効率よく |
| GPT-6 Luna | 決まった作業の繰り返し向け |
Terraの発表で挙がっている例は、提案書の下書き、技術的な図面の読み取り、フォームへの入力、動画の編集です。届いた請求書を読んで会計ソフトに入力する、という大量の作業を自動化する使い方も勧めています。画面や画像を見て、アプリを操作しながら進める仕事を、たくさん回したいとき。そこがTerraの出番です。
使えるのはWorkとCodex、ふだんのChatではまだ選べない
ChatGPTでは、Plus、Pro、Business、Enterprise、Eduのプランで、WorkとCodexから使えます。発表文には使えるプランとしてBusinessの名前がありませんでしたが、ChatGPTの更新情報にはBusinessも含まれています。ヘルプには、Chatでは使えないと明記されています。ふだんの会話の画面でモデルを選ぼうとしても、まだ出てきません。対象のプランでも提供は順次で、会社の管理者の設定によっては、モデルの一覧に出てこないこともあります。
開発者はAPIで gpt-6.1-terra という名前で使えます。Microsoftも、GitHub CopilotとMicrosoft Foundryで使えるようになったと投稿しています。
API料金は6.1 Solの半額。WorkとCodexの利用枠も長持ちする
APIの標準の料金(100万トークンあたり)を、近いモデルと並べるとこうなります。とても長い入力や、処理の方式によっては料金が変わります。
| モデル | 入力 | キャッシュ済みの入力 | 出力 |
|---|---|---|---|
| GPT-6.1 Terra | $1 | $0.05 | $5 |
| GPT-6.1 Sol | $2 | $0.10 | $10 |
| GPT-5.6 Terra(7月の値下げ後) | $2 | $0.20 | $12 |
Terraは発表、6.1 Solは発表、5.6 Terraはモデルの説明によります。6.1 Solと比べると、どの区分もちょうど半額です。5.6 Terraと比べると、入力は半額、キャッシュ済みの入力と出力はそれ以上に安くなっています。トークンの単価で比べると、Astraの10分の1です。
ChatGPTの月額プランで使う人にとっては、利用枠のほうが身近だと思います。公式によると、同じ利用枠で、5.6 Terraより多くの作業をこなせて、6.1 SolやAstraと比べるとかなり多くの作業をこなせます。WorkやCodexで、枠がすぐ尽きてしまうと感じていた人には、Terraに切り替える選択肢ができました。
伸びたのは画面の操作と、事実の正確さ
ここからは性能です。どれもOpenAIが自分で測った数字なので、そのつもりで読んでください。
- 職場のソフトを使いこなす力(Agents' Last Exam): 建築の図面から3Dモデルを作る、アニメ映画を1カットずつ見て記録を作る、といった仕事のテストです。標準的な設定(medium)で、5.6 Terraより15ポイント高く、費用は約3分の1。Astraとほぼ同じ点数を、トークン単価10分の1で出しています
- Claude Opus 5.5との比較: 最高の設定どうしで比べると、使うトークンが3分の1以下、単価が4分の1で、作業1件あたりの費用は約9分の1だとしています
- 速さ: 作業を終えるまでの時間は、AstraやSolの3倍以上速いとしています
- 間違いの少なさ: 間違いを誘うように作った質問で、低い設定での誤答率が53.6%から16.7%に下がりました
- コマンドを使うコーディング(Terminal-Bench 4.0): 最高の設定で、21.5%から50.3%へ倍以上になりました
画面の操作と、事実の正確さ。この2つの伸びが大きいと読みました。誤答率の下がり方は、事実を確かめながら書く文章で期待したいところです。ただ、これはOpenAIが作った「間違いを誘う質問」での結果なので、ふだんの書類で同じだけ減るかは、使って確かめる必要があります。
第三者の測定も、発表と同時に出ています。AIモデルを独自に評価しているArtificial Analysisの結果を、近いモデルと並べるとこうなります。
| 項目 | GPT-6.1 Terra | 比べる相手 |
|---|---|---|
| 総合的な賢さ(最高の設定) | 48点 | 5.6 Terraより6点上、6.1 Solより4点下、GPT-6 Lunaより10点上 |
| テスト1件あたりの費用(最高の設定) | 0.40ドル | 5.6 Terraは1.40ドル |
| コーディングの総合点 | 48点 | 6.1 Solは54点、GPT-6 Lunaは31点 |
| 知らないことを推測で答えてしまう率 | 38% | 5.6 Terraは88% |
誤りが減ったことと、コマンドを使うコーディングで約20ポイント伸びたことは、第三者の測定でも同じ傾向でした。一方で、それ以外のテストの伸びは小さく、コーディングの総合点は6.1 Solに届いていません。答えが長めになりやすい、という指摘もあります。対戦形式で人が評価するLMArenaでは、Terraを試せるようになっていますが、点数はまだ出ていません(10月27日時点)。
難しいコーディングと見た目の作り込みは、まだ上位のモデル
公式の発表は、限界も自分で書いています。いちばん複雑なコーディングには、6.1 SolかAstraのほうが向いている、という一文です。テストの点数が倍になったとはいえ、50.3%は半分です。
Xでは、Opus 5.5とTerraに同じ指示で小さな中庭の3Dの絵を作らせ、費用は14.17ドルと1.23ドルだった、という比較も出ていました。投稿者の評価は、色や光、細部の作り込みでOpusの圧勝です。見た目の作り込みのように、細部の質が問われる仕事では、単価の安さだけでは決められない場面がありそうです。
安全面では、サイバーセキュリティの評価でOpenAIの基準の最高段階(Critical)に達したため、Astraのために作った安全策をそのまま続けている、とされています。安くて速いモデルでも、攻撃に使えるほどの力があるという判断です。
私たちのレビュー作業で比べると、Terraは4分の1の時間で同じ結論を出した
このブログでは、記事を公開する前に、OpenAIのCodexに第三者の目でレビューさせています。事実の誤り、論理の飛躍、言い切りすぎ、AIっぽさ、独自性の5つの観点で指摘を出させる作業です。
10月27日に、同じ依頼を3つのモデルに同時に投げてみました。前の世代のGPT-5.6 Sol、6.1 Sol、Terraです。対象は、2日前に公開したWordPressから静的HTMLへの移行を考える記事です。依頼文も、推論の設定(high)も、Web検索で出典を確かめさせる条件も同じにしています。
| モデル | 終わるまで | 使ったトークン | 公開の判断 |
|---|---|---|---|
| GPT-5.6 Sol | 約5分 | 約15.6万 | 修正してから公開 |
| GPT-6.1 Sol | 約4分43秒 | 約12.6万 | 修正してから公開 |
| GPT-6.1 Terra | 約1分16秒 | 約7.7万 | 修正してから公開 |
Terraは、ほかの2つの4分の1ほどの時間で終わり、使ったトークンも、5.6 Solの約半分、6.1 Solの約6割でした。それでいて、結論は3つとも同じです。中身も、肝心なところは重なっていました。「静的HTMLに移っても、ほかにPHPで動くものが残っていれば入口は消えない」「攻撃が成功したという公的な発表はない、と書くなら、どこを調べたかを示すべき」という2つの指摘は、3つとも出しています。
Terraにしか出なかった指摘もありました。記事で引用しているPHPの公式ページに、10月26日付けで別の更新(Windows版のPHPの作り直し)が追加されていることに気づき、記事の日付より後の情報なので混ぜないように、と書いてきたのはTerraだけです。確かめると、その通りでした。指摘の箇所に行番号を添えてくるので、直す側としても扱いやすい形です。
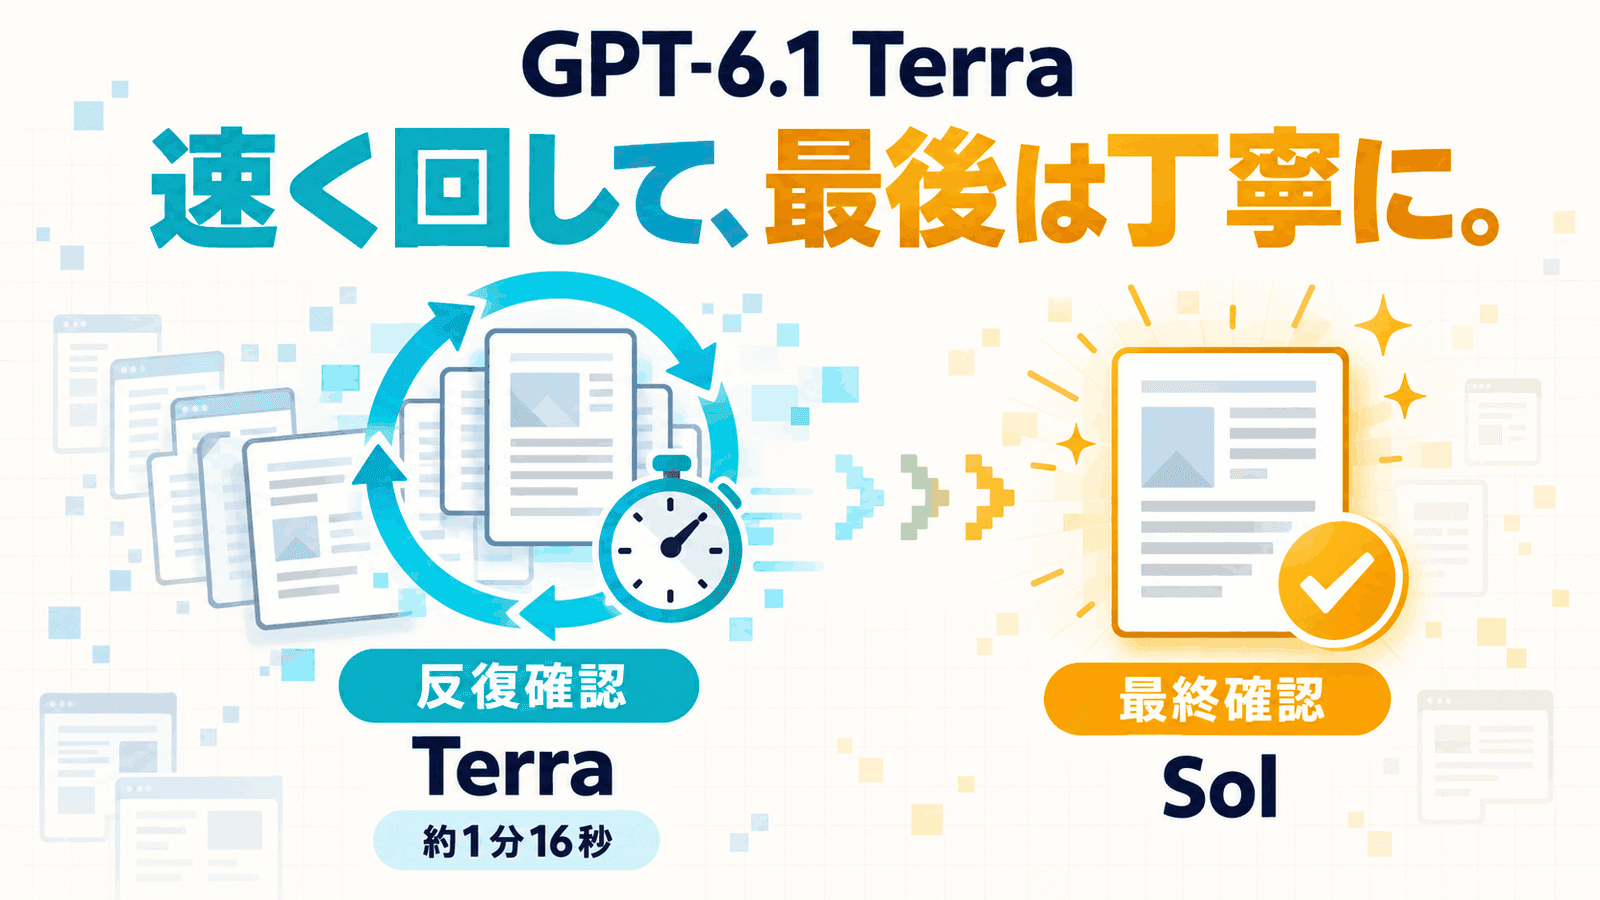
一方で、細かく指摘を拾う量はGPT-5.6 Solがいちばん多く、独自性をどう伸ばすかの提案も具体的でした。1回だけの比較なので、これでTerraの実力を言い切ることはできません。それでも、5分かかっていた確認が1分少しで返ってくると、書きながら何度も回せる手応えはありました。
最後に、日常の書類と画面の作業から、同じ仕事で比べる
Terraは、Astraの代わりではありません。公式も、いちばん難しいコーディングはSolかAstraに任せるよう書いています。試すなら、WorkかCodexで、ふだん頼んでいる仕事をそのままTerraにもやらせて、出来と時間と利用枠の減り方を比べるのがいちばん確かです。公式の点数は、OpenAIが選んだテストの結果にすぎません。
私たちのレビューの比較では、速さの差ははっきり出て、指摘の細かさは上位のモデルが上でした。そこから考えると、書きながら何度も回す確認はTerra、公開前の最後の確認はSol、という分け方が合う仕事は多いのではないかと思っています。5分かかる確認は1日に何度も回せませんが、1分少しなら回せます。速いモデルと丁寧なモデルを、同じ仕事の中で使い分ける。Terraは、その組み合わせを試しやすくしてくれるモデルです。