GPT-6 SolとLuna登場 API料金は半額、ChatGPTはWorkとCodexから

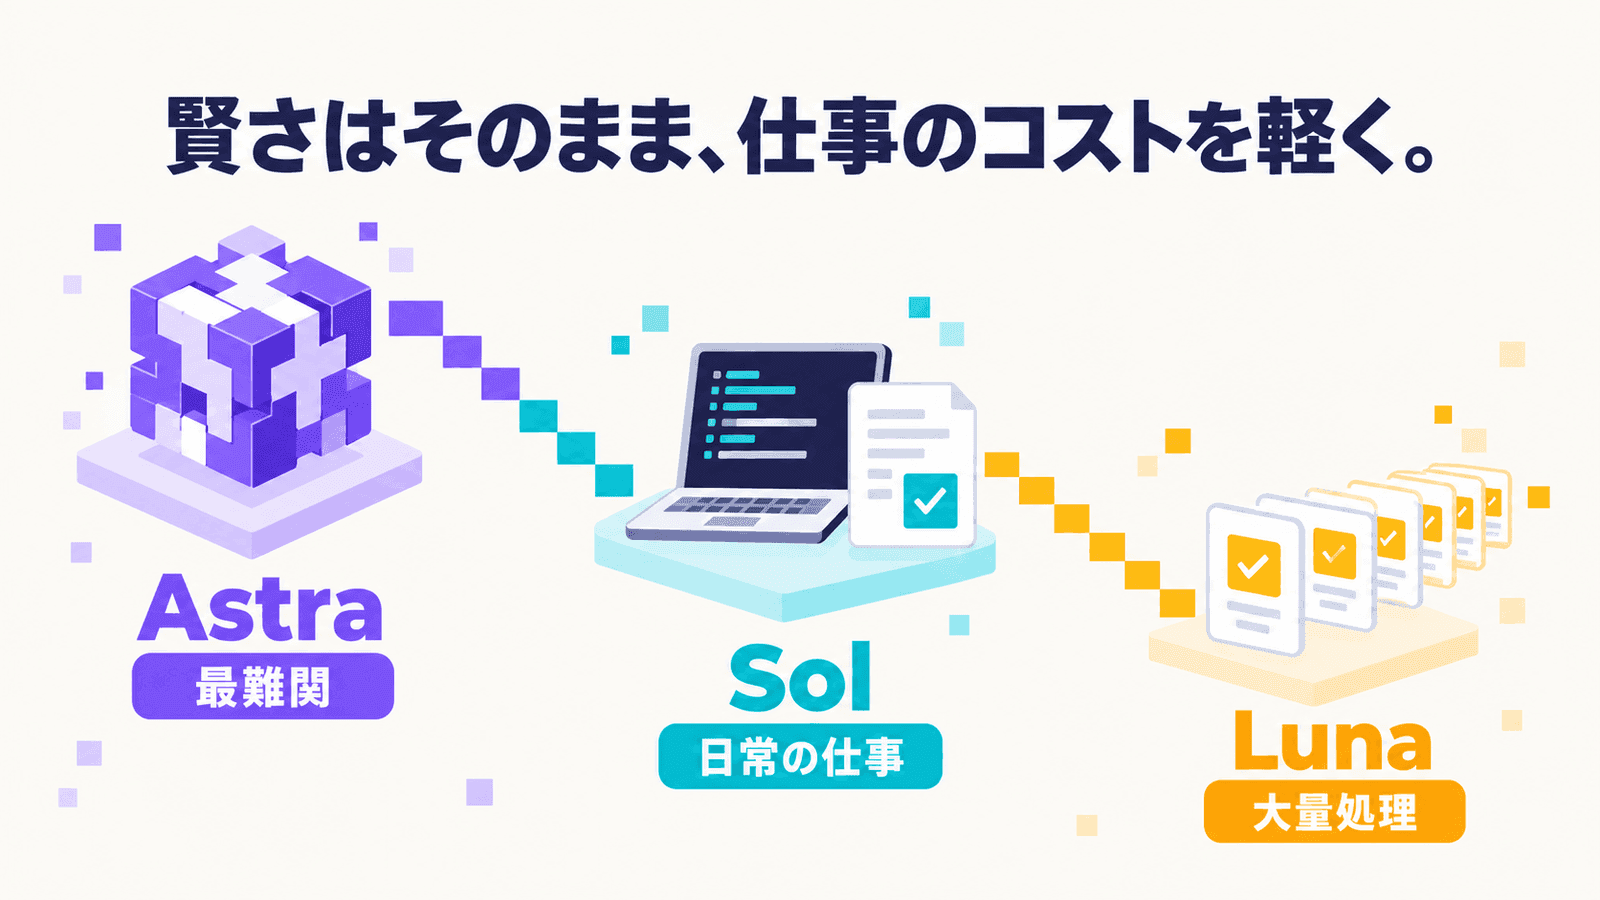
日本時間の9月23日午前3時すぎ、OpenAIがGPT-6 SolとGPT-6 Lunaを発表しました。9月初めに出た最上位のGPT-6 Astraと同様の方法で学習した、中位と小型のモデルです。APIの料金はGPT-5.6(キャンペーン価格)の半額になり、ChatGPTではWorkとCodexで、Plus・Pro・Businessなどの有料プランから順次使えるようになります。AnthropicがClaude Opus 5.5を出した、およそ1時間40分後のことでした。
先に結論を書くと、SolとLunaは賢さを大きく引き上げたモデルではありません。Astra世代の力を、ずっと安く、速く配るためのモデルです。第三者の測定では、賢さの指標は前のGPT-5.6とほぼ同じで、同じ評価にかかった費用は半分以下でした。賢さはそのままで、仕事のコストを軽くした、と言ったほうが近いでしょう。使いどころは「Astraを呼ぶほどではない、毎日の仕事」です。
SolとLunaは、Astraの力を安く配るための中位と小型
発表文によれば、SolとLunaはAstraと同じような方法で学習され、Astraが強かった実務・事実の正確さ・コーディング・パソコン操作・安全面の進歩を、速く手頃なモデルに持ち込んだものです。役割の書き分けは、Solが「複雑なコーディングとエージェントの仕事」、Lunaが「絞り込んだ大量処理」。Astraは引き続き、最高の結果が欲しいときの最上位という位置づけです。
公式ドキュメント(Sol、Luna)の仕様は次のとおりです。
| GPT-6 Sol | GPT-6 Luna | |
|---|---|---|
| 向いている仕事 | 複雑なコーディング、エージェントの仕事 | 絞り込んだ大量処理 |
| コンテキスト(入力・出力・推論の合計) | 約105万トークン(入力は最大約92万) | 同じ |
| 1回の出力の上限 | 12万8,000トークン | 12万8,000トークン |
| 知識の区切り | 2026年4月20日 | 2026年5月18日 |
| 考える量の設定(effort) | noneからmaxの6段階、既定はmedium | 同じ |
API料金は半額、SolはClaude Sonnet 5と同じ値段
料金表で、100万トークンあたりの単価を並べます。比べやすいように、Claudeの料金も入れました。
| モデル | 入力 | キャッシュ読み出し | 出力 |
|---|---|---|---|
| GPT-6 Astra | 10ドル | 1ドル | 50ドル |
| GPT-6 Sol | 2ドル | 0.20ドル | 10ドル |
| GPT-6 Luna | 0.10ドル | 0.01ドル | 0.50ドル |
| Claude Opus 5.5 | 4ドル | 0.20ドル | 20ドル |
| Claude Sonnet 5 | 2ドル | 0.20ドル | 10ドル |
| Claude Haiku 4.5 | 1ドル | 0.10ドル | 5ドル |
Solの単価はClaude Sonnet 5とまったく同じで、Opus 5.5の半分です。Lunaは、Claudeでいちばん安いHaiku 4.5の10分の1。OpenAIは、GPT-5.6の(キャンペーン)価格から、SolもLunaもおおむね半額になったと説明しています(Lunaの出力は約6割減)。表にはありませんが、キャッシュへの書き込みは通常の入力の1.25倍かかります。また、入力が27万2,000トークンを超える依頼は、その依頼全体が、入力とキャッシュは2倍、出力は1.5倍の料金になります。
値下げと同じくらい大きいのが、キャッシュの改善です。同じ前置きを繰り返し送るときの割引(キャッシュ読み出しは通常の1割)が、既定で当たりやすくなりました。考える量の設定やツールの出し入れを途中で変えても、それまでの文脈はキャッシュに残ります。キャッシュが効いた割合を見る画面と、当たらなかった原因を調べる仕組みも加わりました(OpenAI開発者向けの投稿)。発表文によれば、GitHubでは、この数か月の改善で、新しく処理し直す入力の割合が半分以下になったそうです。どこまで請求に響くかは使い方しだいですが、同じ前置きを何度も送る長い会話やエージェントの作業ほど、差が出やすい部分です。
賢さは前世代並み、変わったのは費用
第三者の評価機関Artificial Analysisは、SolとLunaについて「GPT-5.6に比べて費用を半分にし、賢さの指数はGPT-5.6と同じ水準。伸びた評価も、下がった評価もある」とまとめています。同社のモデル別ページ(Astra、Sol、GPT-5.6 Sol、Luna、GPT-5.6 Luna)の数字(いずれも最大設定)を並べると、こうなります。
| モデル | 総合指数 | 評価全体にかかった費用 |
|---|---|---|
| GPT-6 Astra | 53 | 約5,320ドル |
| GPT-6 Sol | 48 | 約1,550ドル |
| GPT-5.6 Sol | 47 | 約3,460ドル |
| GPT-6 Luna | 37 | 約120ドル |
| GPT-5.6 Luna | 37 | 約320ドル |
Solは前世代より1点上がっただけですが、同じ評価にかかった費用は半分以下です。Astraと比べると5点低く、費用は3割弱。Lunaは点数が変わらず、費用は4割弱まで下がりました。「賢くなった」より「安くなった」が正確な表現だと思います。Xでも「安くて効率的だが、賢いモデルではない」という指摘が約800いいねを集め、日本語圏でも「半額になってびっくりだけど性能はほぼ横ばい?」という受け止めが見られました。
OpenAI自身は、別の角度の数字を出しています。いちばん目を引くのは事実の誤りで、ユーザーが過去に誤りを報告した会話をもとにした社内評価では、Solの誤りが前世代の約半分に減り、Astraに近づいたとしています(ふだんの会話を代表する評価ではない、とも注記しています)。ほかに、複数のアプリをまたぐ業務の評価(AutomationBench)で、最高に近い設定のSolが33.2%を取り、最大設定のClaude Opus 5(26.9%)を1件あたり11分の1の費用で上回った、という比較も載っています。
ここで気をつけたいのは、比べている相手です。OpenAIの比較相手はOpus 5で、その1時間40分前に出たOpus 5.5は入っていません。Anthropicの発表では、同じAutomationBenchでOpus 5.5(最大設定)が40.0%でした。測った条件も費用の出し方も違うので、どちらが上とは言えません。比較表の相手が最新のモデルとは限らないので、誰と、どの設定で比べたかを確かめて読むのが無難です。同じ評価一式で測ったArtificial Analysisの数字では、Opus 5.5の最大設定は58点、費用はSolの最大設定の約5.6倍でした。一方、Opus 5.5のmediumは51点で約1,630ドル。Solの最大設定(48点、約1,550ドル)とほぼ同じ費用で、点数は3点上です(詳しくはOpus 5.5の記事)。
ChatGPTではWorkとCodexから、ふだんのChatではまだ選べない
提供の範囲は、発表文にこう書かれています。
- ChatGPT: WorkとCodexで、Plus・Pro・Business・Enterprise・Eduに当日から順次。FreeとGoは、デスクトップアプリでLunaを試せる
- API:
gpt-6-solとgpt-6-lunaで利用可能 - まだ使えないところ: ChatGPTの「Chat」(ふだんの会話)
ChatGPTにはChat・Work・Codexの3つの入口があり(ChatGPT Workの記事)、有料プランでは今回の2モデルはWorkとCodexに入りました。ふだんのChatでは、まだ選べません(Free・Goは、デスクトップアプリでLunaだけを試せます)。Xでも「なぜChatで出さないのか」という不満が1,000いいねを超えています。
定額プランの人には、別の知らせもあります。CodexとChatGPTを担当するOpenAIのTibo氏は、値下げでサブスクリプションでも利用枠が長持ちすること、そしてPlus・Pro・Businessの全アカウントに「バンク済みリセット」を入れたことを投稿しています。公式ヘルプによれば、これはCodexの5時間と週の利用枠を、好きなときに1回だけ満タンに戻せるもので、デスクトップアプリ・CLI・Webの「設定→使用量」から使い、期限はアカウントに表示されます。Anthropicも有料プランに同じようなリセットを配っていて、両社が同じ手を打った形です。
9月には、Astraの利用枠が短時間で尽きるという声が相次ぎました(Astraの利用枠の記事)。ふだんの作業をSolに回し、同じ作業で利用枠の減り方が小さければ、そのぶんAstraを本当に難しい仕事に回せます。今回の発表は、その問題への答えとしても読めます。
Astraは最難関に取っておき、日常はSol、大量処理はLuna
ここまでが発表と測定で分かっていることです。ここから先は、それを踏まえた筆者の見方です。
2社の発表は、どちらも「同じくらいの賢さを、もっと安く」でした。Anthropicは、Fable 5.1並みとうたうOpus 5.5をOpus 5より4割安く。OpenAIは、GPT-5.6並みの賢さのSolとLunaを半額に。競争の軸が「いちばん賢いのはどれか」から「1件の仕事をいくらで終えられるか」に移ってきた、と筆者は見ています。
使い分けは、次の形から試すのが現実的だと思います。いずれも、自社の仕事で精度を確かめてから本番に入れる前提です。
| 仕事 | OpenAIで試すなら |
|---|---|
| 結果が何より大事な難題、長く任せる仕事 | Astra |
| ふだんの調べもの、文章、Codexでの開発 | Sol |
| 分類、抽出、要約のような、同じ形の大量処理 | Luna |
参考になるのが、米メディアEveryのCEO、Dan Shipper氏が実際の業務でSolとOpus 5.5を比べた所感です。Solは、Astraには及ばないものの日々の仕事の多くには十分で、速く、GPT-5.6 Solの半額。Codexでの新しい常用モデルになったそうです。一方で、長く自律的に開発させたときの上限は、Opus 5.5のほうが高かったと書いています。一人の使用例ですが、Artificial Analysisの総合指数でもOpus 5.5がSolを上回っていて、向きは合っています。「日常はSol、難しい開発はOpus 5.5」という線引きは、筆者も無理のない仮説だと思います。
私たちも、このサイトの記事制作では、文章はClaude、画像の生成と原稿の第三者レビューはCodexと、1社に寄せずに仕事ごとに分けています。値下げと新モデルがこれだけ続くと、この組み合わせは数か月ごとに見直す価値があると思います。
APIで使う場合は、Lunaの安さを大量処理に当てる前に、自社のデータで精度を確かめてください。問い合わせの振り分けや請求書の項目の抜き出しのように、答えの形が決まっている仕事なら、入力2,000トークン、考える分も含めた出力200トークンで、1件約0.05円(1ドル150円、ツールの利用料などは除く)の計算です。私たちが問い合わせの営業判定に使っているJevの1件0.013円と同じく、1円を大きく下回る桁です。ただ、大量に自動で流すほど、間違いも大量に流れます。何件中何件合っていれば採用するか、見逃しと誤検知のどちらを重く見るか、人がどこを確かめるかを、流す前に決めておく必要があります。
最後に 自分の入口で使えるかを確かめ、同じ仕事で比べる
すぐに試すなら、次の順番です。
- ChatGPTのWorkかCodexを開き、モデルにSolとLunaが出ているかを確かめる(当日中に順次展開、Chatではまだ選べない)
- ふだんAstraで回している作業を1つSolで流し、結果と利用枠の減り方を比べる
- APIで大量処理をしているなら、採用の基準を先に決めてから、同じ100件をLunaとClaude Haiku 4.5で流し、精度と費用を並べる
次に見るのは、ふだんのChatにいつ入るか、配られたリセットの使い方と期限、そして独立した評価でSolがOpus 5.5やSonnet 5とどう並ぶかです。Anthropicは、Sonnet 5.5とHaiku 5.5を数週間以内に出すと予告しています。SolとLunaの値段を見たうえで、その料金がどこに置かれるかも気になるところです。