Jevを実際に使ってみた 問い合わせフォームからの営業メールを0.013円で自動仕分け

前回、TypeSafe AIのJevについて書いた記事は、「文章が要らない判断を、まず3つ探す」で終えていました。日本語の精度は未確認、私たちも実機では試していない、とも。その宿題を1つ、自分たちで片づけました。自社サイトの問い合わせフォームに届く営業メールの仕分けです。
結果を先に書きます。合成データ73件の評価で、正規の問い合わせに営業やスパムのタグを付けた誤判定はゼロ。営業とスパムは全件に何らかのタグが付き、1件あたりの応答は平均0.3秒、費用は0.013円。今回と同じくらいの長さの本文なら、1,000件届いても13円です。判定のためにJevへ渡す送信者の入力は、用件「その他」で書かれた本文だけで、氏名・会社名・メールアドレスは渡していません。作るのに使ったAPI代は、評価を4周回して約5円でした。
ただし、この数字は本番の問い合わせで測ったものではなく、私たちが用意した合成データでの数字です。本番では9月20日から動き始めたところで、実際の営業メールにどこまで当たるかは、これから分かります。数字の大きさより、何を渡して何を渡さないか、外れたときに何が起きるかのほうが、この記事の本題です。
営業メールは「その他」に集まる
私たちのサイトの問い合わせフォームは、最初に用件を選ぶ作りです。「当社サービスについて知りたい」「開発・AI導入の相談」「協業・取材のご連絡」、そして「自社の製品・サービスを提案したい」。営業の方のための入口は、6月から用意してあります。ただしこの入口は、提案の概要、当社に提案する理由、当社サービスとの関連、費用対効果など、当社向けの回答を求める5問(各20文字以上)が必須です。テンプレートをそのまま貼るには向かない入口です。
すると何が起きるか。営業メールは「その他」に来る。少なくとも私たちのフォームではそうでした。用件を選ぶ手間もなく、自由記述の欄が1つあるだけの入口だからです。
正直なところ、件数の記録は取っていません。ただ、私の実感としては、かなりの数の営業目的の問い合わせが入ってきていて、ほとんどの場合、その内容は無意味であり迷惑でした。実測ではなく経験からの仮説ですが、他の分岐は選択式が中心で、自由記述だけの入口は「その他」しかない。ならば、まず「その他」だけを判定すればよい。営業の入口を正しく選んでくれた方は、件名の用件で分かるので判定しません。他の分岐を選んで自由記述に売り込みを書く人は今の設計では素通りしますが、そこは本番で様子を見てから広げるつもりです。
渡すのは本文だけ。氏名・会社名・メールは渡さない
外部のAIに問い合わせを読ませる以上、何を渡すかを先に決めました。
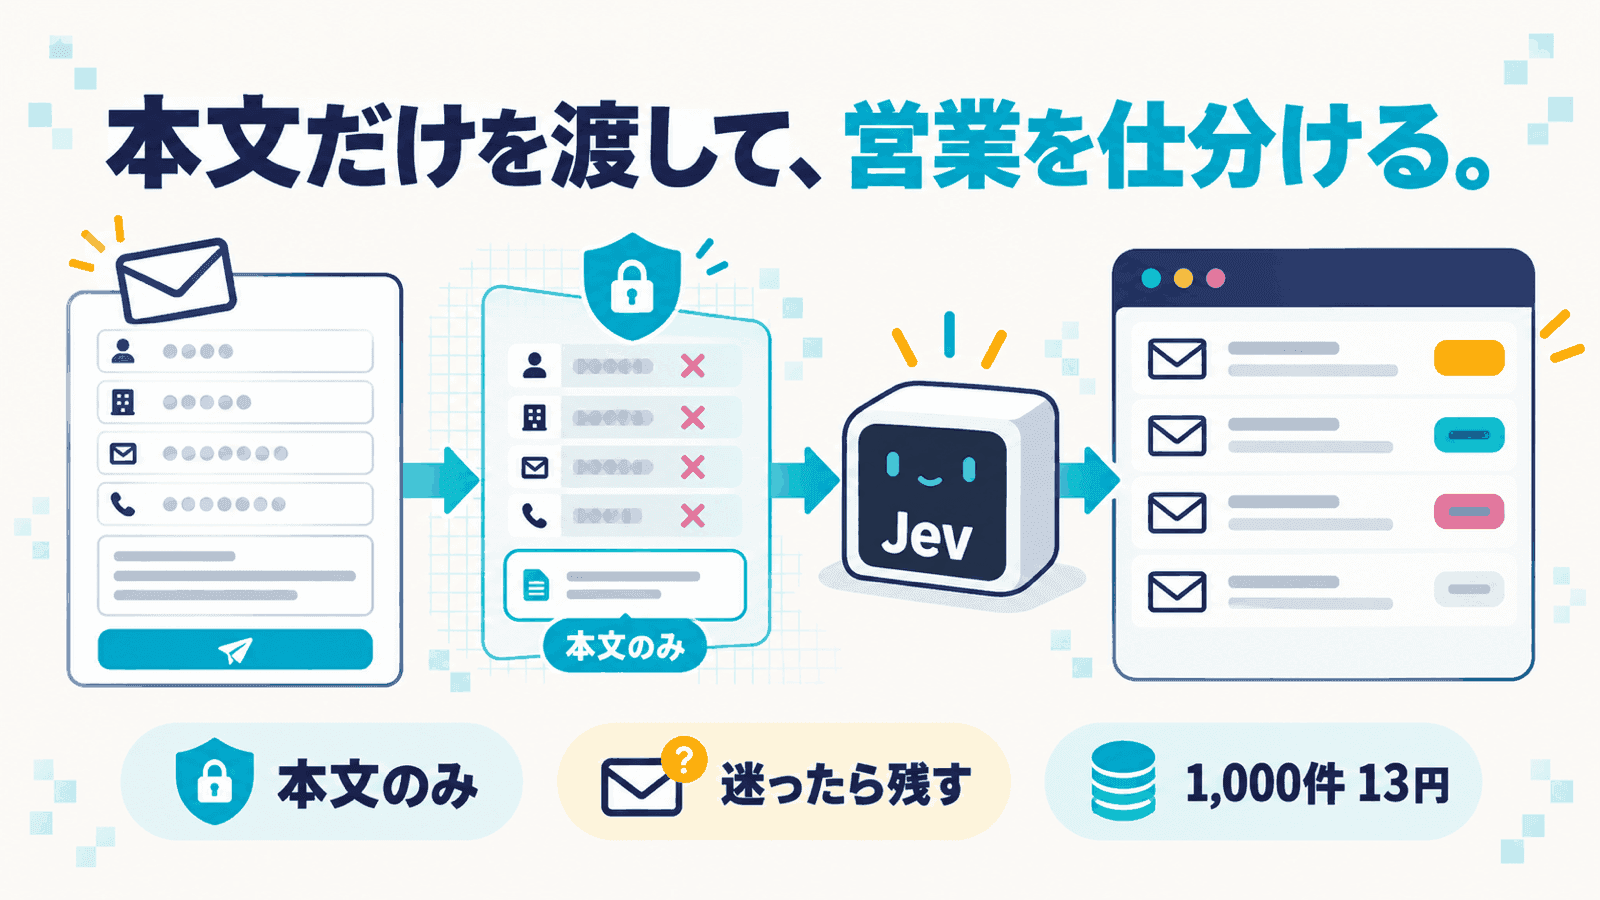
Jevに渡すのは、用件「その他」で書かれた自由記述の本文のみです。フォームで選んだ用件の選択肢(「その他」というラベル)、氏名、会社名、メールアドレス、送信元のIPアドレスは渡しません。本文の中に送信者自身が書いた電話番号やメールアドレスも、渡す前に [PHONE] [EMAIL] に置き換えます。この置き換えはAIではなく、電話番号やメールアドレスの形を文字列のパターンで見つけて書き換える、昔ながらの正規表現をコードで走らせているだけです。URLはドメインだけを残します(営業判定の材料になる一方で、パスには追跡用のIDが含まれることがあるためです)。ただし、置き換えるのは電話番号・メールアドレス・郵便番号・URLの形をしたものだけで、本文に書かれた氏名や住所そのものまでは消せません。TypeSafe側は、顧客のリクエストや応答でモデルを学習しないこと、入力を業務委託先以外の第三者に渡さないことを公式に書いています。一方で、データの保持はゼロではなく、プライバシーポリシーでは、サービスの提供や事業上の目的に必要な期間は保持するとしています。保持ゼロ(ZDR)は企業顧客向けに提供される選択肢です。「学習しない」と「残らない」は別の話なので、ここは切り分けて読む必要があります。
判定の結果も、メールの件名に [営業] のようなタグを足すだけにしました。宛先は変えません。営業と判定したものを別の受信箱に隔離する案もあったのですが、私の判断で件名タグだけにしました。振り分けはメールソフト側で実施すればよく、それなら「受信されなかった」ということにはならないからです。Gmail側で、件名に [営業] か [spam] を含むメールを受信トレイから外してラベルを付けるフィルタを設定して、振り分けが完成します。誤判定があっても、メールが消えることも、別の宛先に行くこともありません。弱いタグの誤判定は受信トレイにそのまま残り、強いタグの誤判定はラベルの側に残るので、ラベルのほうも定期的に目を通します。「届かなかった」だけは起きない、という設計です。
もう一つ、Jevが落ちても、遅くても、タグなしで普通に送る設計にしました(1回3秒で打ち切り、再試行は1回)。判定機能を足したせいで問い合わせが届かなくなるのが、一番の損失だからです。その代わり、Jev側に障害があるときは、送信者が送信完了まで最大6秒ほど余計に待つことになります。
Jevには7つの質問を1回で聞き、判断はコードで決める
前回の記事で書いたとおり、Jevは文章を生成しません。渡した材料に対して、型の決まった質問に「どれか」「本当か」「何点か」を確率つきで答えるだけです。だから設計は、「営業かどうか」という大きな問いを、知識のある人なら数秒で決められる小さな問いに分けるところから始まります。
今回は7つです。
| 型 | 質問(要旨) | 返るもの |
|---|---|---|
| Choice | 送信者の主目的は、問い合わせ / 営業 / スパム / その他のどれか | 各選択肢の確率 |
| Noul | 送信者は自分の商品・サービスを売り込んでいるか | 0〜1 |
| Noul | 当社の具体的なサービスや事業に触れているか(「貴社」だけでは不可) | 0〜1 |
| Noul | どの会社にもそのまま送れる文面か | 0〜1 |
| Noul | 意味の通らない文字列か | 0〜1 |
| Noul | 認証情報や支払いの要求、脅し、心当たりのない報酬があるか | 0〜1 |
| Score | 提案内容は当社の事業や歓迎する連絡にどれくらい近いか(3段階) | 点数 |
本文と一緒に渡す材料は、当社の事業内容、歓迎する連絡(サービスの利用相談、開発の相談、事業に即した協業、取材)、不要な売り込み(SEO、営業リスト、テレアポ代行、求人媒体、汎用SaaS、補助金コンサルなど)を数行で書いた自社プロファイルです。「営業リスト」「テレアポ」といった語の有無で決めるキーワード方式とは違い、Jevは文脈で読みます。
7つの質問は1回の呼び出しで並列に評価され、判断はすべてコード側です。「正規の問い合わせである確率」(問い合わせ+その他)が0.9以上なら原則タグなし(ただし自社商材の売り込みが強く当社事業と関係が薄ければ [営業?]、詐欺の疑いが強ければ [要確認])、0.6以上0.9未満なら [要確認]、それ未満で営業が優勢なら営業のタグ、スパムが優勢ならスパムのタグ。営業のタグも一段階ではなく、当社を名指しして事業に直接関係する提案なら [営業/関連あり]、どの会社にも送れる文面なら [営業]、迷うなら [営業?]。受信トレイから外すのは [営業] と [spam] だけで、? のついたタグと [要確認] は受信トレイに残ります。迷ったら残す、が方針です。
なお、URLだけの本文や記号の羅列は、Jevに聞く前にコードでスパムと確定させています。数え上げや計算はJevが苦手だと公式が明記しているので、URLの数もコードで数えて渡しています。
Jevは理由文を書けません。代わりに、7つの質問の確率をすべてメールの末尾に載せました。誤判定を見つけたときに、どの質問がどう答えたかを見て閾値を直すための材料です。
合成データ73件で誤判定ゼロ、営業・スパムは全件検知
評価には、過去に届いた実際の問い合わせを使っていません。これも私の判断です。代わりに、正規の問い合わせ、営業、スパム、その他(求人応募やクレームなど)を合わせて98件の合成データを書き、境界例を意図的に混ぜました。本番の構成(用件「その他」の本文だけを判定)では、本文のない選択式だけの送信は判定対象にならないので、それを除いた73件で測っています。先に断っておくと、閾値はこの同じデータの結果を見ながら決めたので、下の数字は独立した精度評価ではなく、設計が意図どおりに動くかの確認です。
| 指標 | 結果 |
|---|---|
誤タグ率(正規の問い合わせに [営業] [spam] が付いた割合) | 0%(0/44) |
要確認率(正規に [要確認] が付いた割合) | 4.5%(2/44) |
| 営業の検知率(何らかの営業タグ) | 100%(14/14)。内訳は [営業] 11、[営業?] 2、[営業/関連あり] 1で、受信トレイから外れる [営業] は11/14 |
| スパムの検知率(何らかのタグ) | 100%(15/15)。[spam] は10/15 |
| 応答時間 | 平均0.3秒、95%が0.6秒以内 |
| 入力トークン | 平均2,069/件 |
境界例の実物をいくつか。
- 「御社に営業のご提案をしたいわけではありません。純粋に、TalentCloudの機能の導入事例の数字を知りたいです」→ タグなし。正規の確率1.0
- 「担当営業の方の説明と契約内容が違っていました。責任者の方から連絡をください」→ タグなし。「営業」という語を含むクレームで、キーワード方式なら誤爆する例
- 「弊社はSEOコンサルティング会社です。顧客満足度調査をKicueで実施したい」→ タグなし。送信者の業種は「不要な売り込み」の側ですが、用件は利用相談なので正しい
- 「取材のご依頼です。ビジネス誌の特集に掲載したく、掲載料として30万円をご負担いただきます」→
[営業?]。受信トレイに残る - 「採用コンサルティング会社です。TalentCloudを弊社クライアントに提案したいので、代理店契約が可能か」→
[要確認]。人が読んでも判断が分かれる例で、残るのが正解だと思います - ロシア語の医薬品の広告 →
[営業]。スパムではなく営業と読みましたが、振り分け先は同じです
公式は「英語が主な学習言語で、CJK(中国語・日本語・韓国語)を含む他の言語は同じ精度ではない。自分のデータで試してから使うように」と書いています。試した結果、少なくともこの合成データでは、日本語でも分離は明瞭でした。正規の問い合わせ44件のうち41件が「正規の確率」0.95以上(最低は0.74)、営業は最大でも0.56、スパムは最大0.02。0.6〜0.9の帯に落ちたのは、上の境界例2件だけです。質問文を日本語で書いたセットとも比べましたが、結果は同等で、トークンが24%多くなる(2,066→2,558)ので、英語の質問文に日本語の例文を添える形にしました。
1件0.013円、1,000件で13円。生成LLMなら数百円から約2,100円
Jevの料金は、入力100万トークンあたり0.042ドルで出力は無料です(公式、2026年9月17日時点。早期アクセス中で、レート制限は予告なく変わると書かれています)。1件2,069トークンなら0.0000869ドル。1,000件で0.087ドル、1ドル150円なら13円です(160円で計算しても14円)。
本文が短くても2,000トークン前後かかるのは、7つの質問文と自社プロファイルを毎回一緒に送るからで、今回の合成データではこの固定部分が大半でした。本文が長ければその分は増えます。フォームの上限いっぱいの5,000字を書かれても数倍の範囲で、桁は変わらないと見ています。
開発から評価までにJevを呼んだのは380回ほど、約82万トークンで、0.034ドル、約5円でした。98件のセットを英語の質問文、日本語の質問文、閾値の変更後で3周、本番構成の73件で1周回し、境界例を個別に確認し、開発サーバーからの送信テストをした分です。「試してから決める」の値段としては、無視してよい額だと思います。
かかった時間も書きます。TypeSafeのアカウントは順番待ちでしたが、登録時のアンケートに答えたためか半日ほどで発行され、APIキーはその場で作れました。キーを受け取ってから、判定モジュール、単体テスト31件、合成データ、評価スクリプト、フォームへの組み込み、開発サーバーでの動作確認までが約30分。Claude Codeに公式ドキュメントとSDKのソースを読ませて書かせています。質問を分解して1回で聞き、コードで振り分ける骨格は、公式の意図の振り分けパターンから借りたものです。渡す入力を本文に絞ること、個人情報の置き換え、Jevに聞く前のルール、落ちたときにタグなしで送る作り、タグの強弱は、自分たちで足した部分です。
同じ判定を、文章を生成する普通のLLMにやらせたらいくらになるか。同じデータで両方を測ったわけではないので机上の試算ですが、比較のために置いておきます。入力を同じ2,069トークン(トークンの数え方はモデルごとに違いますが、比較のため同数と仮定します)、出力を判定結果のJSONで150トークンとして、Anthropicの公式料金(2026年9月20日時点)で計算しました。
| モデル | 料金(入力 / 出力、100万トークンあたり) | 1件 | 1,000件 |
|---|---|---|---|
| Jev(jev-1.13.0) | 0.042ドル / 無料 | 0.013円 | 13円 |
| Claude Haiku 4.5 | 1ドル / 5ドル | 0.42円 | 約420円 |
| Claude Sonnet 5 | 2ドル / 10ドル | 0.85円 | 約850円 |
| Claude Opus 5 | 5ドル / 25ドル | 2.1円 | 約2,100円 |
一番安いHaikuでもJevの30倍、Opusなら160倍です。ただし、LLM側は質問文とプロファイルの固定部分をキャッシュできれば、その部分の入力単価を1割程度に下げられます(本文の分と、キャッシュを書き込む回は別料金です)。逆に推論を長く使う設定なら出力代が膨らむので、差は桁の目安として読んでください。その代わりLLMには、判定の理由文まで書いてもらえます。1,000件で数百円なら、どちらでも払える額です。違いが出るのは、全件を毎回、次の処理を待たせずに判定したいときで、Jevの速さと安さはそこで意味を持ちます。
最後に 本番の数字はこれから。そして、このブログを読んだ営業の方へ
ここまでの数字は合成データの上の話で、本番の営業メールは、もっと巧妙で、もっと雑です。
公式が挙げる弱点のうち、この用途に関係するのは2つ。質問を字義どおりに読むこと、そして「自分の分類を主張する文面」に判定が動きうること。「これは営業ではありません」と書けば、判定はいくらか動くかもしれません(上の例では動きませんでしたが、保証はありません)。ただ、この手の文面で動く先は「営業メールがタグなしで受信箱に届く」、つまり今までどおりです。逆方向、正規の問い合わせに強いタグが付く誤判定は、合成データではゼロでしたが、本番でゼロという保証はありません。
本番は9月20日から動いていて、Gmailのフィルタも設定済みです。2週間ほど、届いたメールの末尾の判定値を見て、誤タグがゼロのまま続くかを確かめます。誤判定が出たら、氏名や連絡先を除いた形で評価データに足し、閾値を直して、増えた評価セットを全件回す。この繰り返しが1周1〜2円なら、気軽に回せます。
ここまで読んだ営業の方は、お気づきかもしれません。当社を名指しし、当社の事業に直接関係する提案を、テンプレートではなく個別に書けば、このフィルタは通ります。[営業/関連あり] は受信トレイに残る設計ですから。
それでいいと思っています。当社向けに書いてくださった提案は、読みたい。判定の質問はそういう文面を通すように書いてあり、フォームの営業用の入口も同じ考えで作ってあります。回避策を探すより、その入口から書いていただくほうが早いです。
自社のフォームでやってみるなら、順番はこうです。まず、営業が集まる入口を1つ特定する。次に、「歓迎する連絡」と「不要な売り込み」を数行で書き出す。ここが書けないと、Jevでも生成LLMでも判定は書けません。書けたら、実際の問い合わせを使わずに合成データを数十件作り、誤タグゼロを最優先に閾値を決める。届かなかった問い合わせ1件は、営業メール100通より高くつきます。
次に書くのは、本番2週間の結果です。