TypeSafe AIのJevとは何か 文章は書かないが業務の判断を低コストで速く提示するAI

日本時間の9月16日未明、TypeSafe AIという会社が最初のモデル「Jev」を発表しました。創業者のDiogo Almeida氏は、ChatGPTにも使われたRLHFという学習手法を示したInstructGPT論文の著者の一人で、元Google Brainの研究者です。本人のXでは「ChatGPTを共同発明したあと、ずっと自問してきた。チャットで超人になったモデルが、なぜAGIにつながらないのか」と書いています。2年間ステルスで作って出した答えが、Jevです。
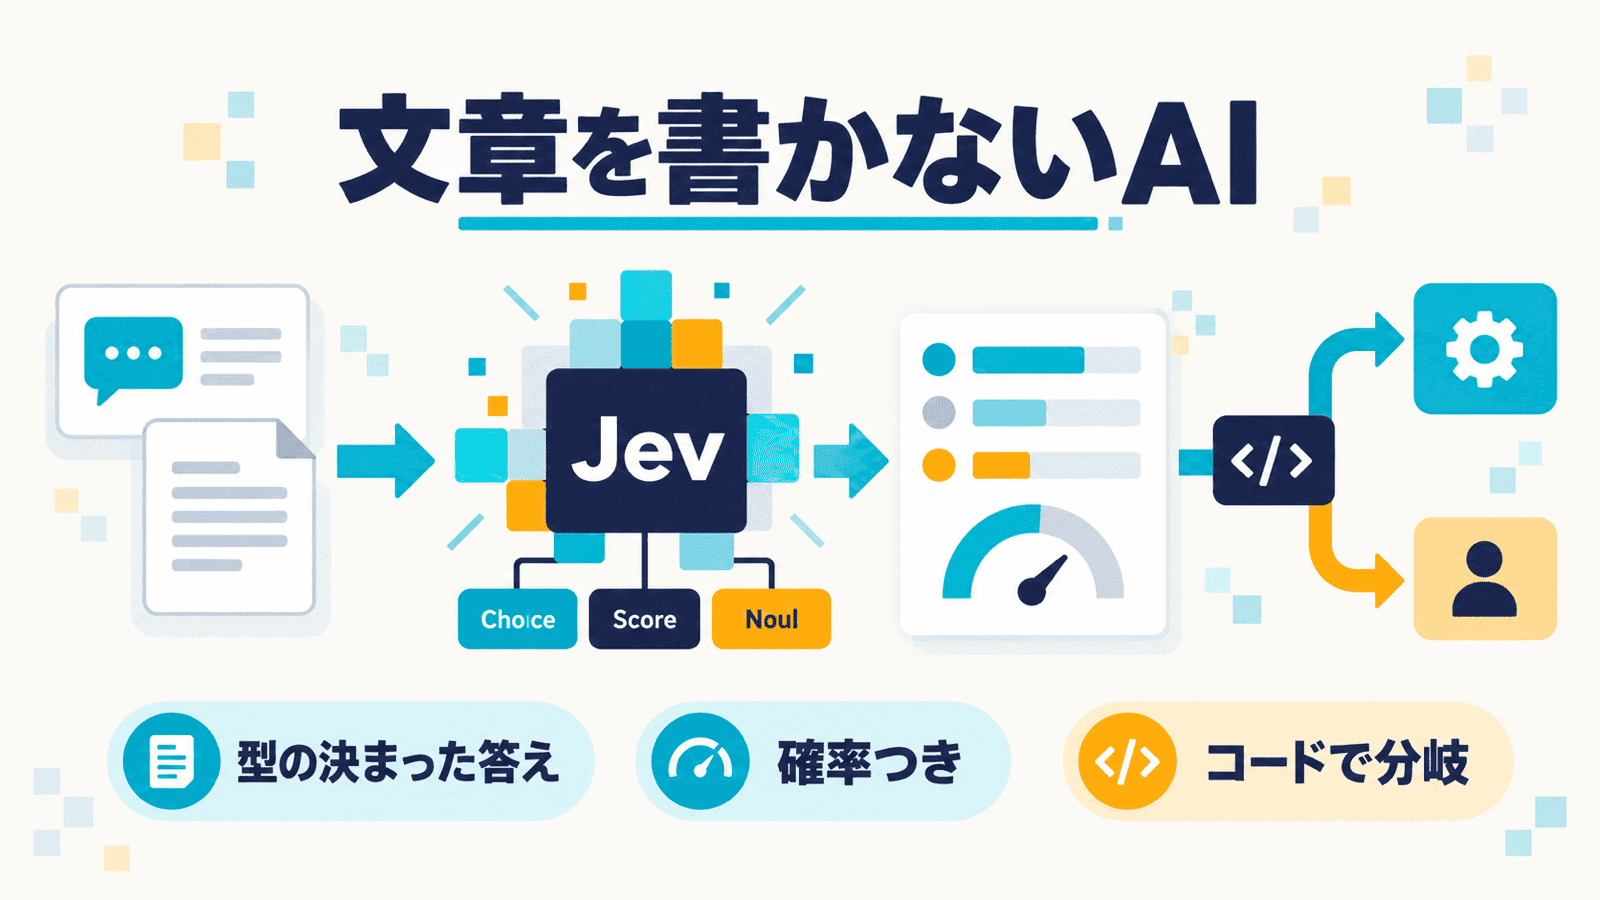
Jevが何なのかは、一言で言えます。文章を書かないAIです。質問を投げても、返事もコードも説明も書きません。Jevが返すのは「どれか」「何点か」「本当か」という答えと、その確率だけです。これまでのLLMが捨てなかったものを捨てて、その代わりに速さと安さと、答えの形が崩れない保証を手に入れた、というのが本人の主張です。この記事では、何ができて、何ができず、中小企業の業務のどこに置けるのかを、公式の文書と本人の発言で確かめます。公開時は早期アクセス(順番待ち)でしたが、9月16日以降は順次開放され、OpenRouterなどの中継サービスからも使えるようになりました(後半の「公開から3日で変わったこと」の章)。筆者は実機ではまだ試せていません。先に触った第三者の結果は後半で紹介します。(9月21日追記: その後、自社の問い合わせフォームに組み込んで営業メールの仕分けを試しました。結果は別の記事にまとめています)
Jevが返すのは文章ではなく、答えと確率
Jevに渡すのは2つです。判断してほしい材料(問い合わせの文章、書類、アプリの状態など)と、型の決まった質問。質問の型は3つしかありません。
| 型 | 聞き方の例 | 返るもの |
|---|---|---|
| Choice | どの部署が担当すべきか | 選んだ選択肢と、各選択肢の確率、確信度 |
| Score | 顧客はどれくらい怒っているか | 段階の点数と確信度 |
| Noul | この文は急ぎか | 0〜1の確率 |
公式の入門ページにある例が分かりやすいです。「Stripeの接続が3日間失敗していて売上が落ちている、すぐ助けてほしい」という問い合わせ文を渡し、3つの質問を同時に投げると、次のような答えが返ります(小数は第2位あたりで丸めています)。
- 担当部署: technical(確率0.84。billingが0.16、salesが0.001)、確信度0.60
- 怒りの度合い: 1.04(0=冷静、1=不満だが丁寧、2=激怒、の3段階)、確信度0.84
- 急ぎか: 0.999
ここで大事なのは、3つの質問が1回の呼び出しで、並列に、互いに独立して評価されることです。公式は「質問を増やしても応答時間はほとんど変わらない」「質問同士が干渉しないので、文脈が長くなって答えが劣化する問題が起きない」と書いています。LLMに10個の判断を1つの出力にまとめて頼むと、前の答えが後の答えに影響し、聞く順番で結果が変わることがありますが、Jevは少なくともその生成順による干渉が起きない設計です。
「ハルシネーションしない」の正確な意味
発表文には「Jevはハルシネーションできない」とあります。ここは意味を正確に押さえる必要があります。Jevがしないのは、型の外の答えを出すことです。選択肢がbilling、technical、salesの3つなら、その3つ以外は返ってきません。JSONの形が崩れることも、存在しない項目名を作ることもない。公式はこれを「型のエラーは数学的に不可能」と書いていて、反例が1つあれば崩れる主張なので確かめやすい、とも言っています。
一方で、選んだ答えが正しいかどうかは別の話です。公式ドキュメントのSystem Oneの説明には「確率の当たり具合は予測の集まりに対して測るもので、個々の答えが正しいことを保証するものではない」と明記されています。「technical 0.84」は、確率がよく合っているモデルなら、0.84前後で答えたケースを集めるとおよそ84%が正しい、と期待できる値です。この1件が正しいという意味ではなく、自社の用途で本当にその割合になるかは、自分のデータで測るしかありません。
その代わりに手に入るのが、「分からない」を言える仕組みです。確率がどれか1つに集中していれば確信が高く、ばらけていれば低い。ChoiceとScoreにはこれを0〜1にまとめた確信度が付き、Noulは0〜1の確率そのものを見ます。コードの側で「確信が高ければ自動で進め、低ければ人に回す」と書けるのはそのためです。公式の確信度の解説にある言葉を借りると、「正直に不確かさを表現できないシステムは、人でも機械でも信用できない」。LLMに「自信はどれくらい?」と聞いても過信気味で一貫しない、というのが本人たちの見立てで、そこを学習の目標そのものに据えたのがJevです。
なぜ速くて安いのか、そのために何を捨てたか
数字は目を引きます。発表文によると、同社の測定で応答は70〜500ミリ秒。入力は百万トークンあたり0.042ドルで、出力は「安すぎて課金しない」。同じ比較表では、既存のLLMが入力0.20〜10ドル、応答3〜329秒とされています。トップページには「Claude Fable 5.1より入力価格が238分の1」とも書かれています。どれもTypeSafe自身が出した数字です。
速さの説明はこうです。LLMは1トークンずつ、前のトークンを見ながら順番に生成します。Jevは文章生成を捨て、全部の答えを1回で並列に出す。そのために、モデルの構造、並列に答えを出す仕組み、学習法(RLCD)を新しく作った、と発表文は説明しています。本人はXで「逐次計算を並列に置き換えるのは、TransformerがRNNを追い抜いたのと同じ手」と書いています。
その代わり、Jevは文章を生成できません。本人も同じ投稿で、この点を代償としてはっきり書いています。返事を書く、コードを書く、判断の理由を説明する、のどれもできません。長い推論を要する問いにも向かないと公式は書いていて、「知識のある人が数秒で判断できる種類の問い」に絞れ、と繰り返しています。会社のサイトには「Not Chat」と大きく書いてあります。
背景には、本人がRLHFを作った側だからこそ言える見立てがあります。RLHFは「人間の評価者が好む文章」を学習の目標にした。それはチャット製品には正しい目標だったが、自動化には間違った目標で、自信過剰やムラの一因になり、結果として人が常に見ていないと使えないモデルになった、というのがTypeSafeの主張です。同社はこれを「もっと苦い教訓」と呼び、データや計算量やアルゴリズムより、正しい課題を選ぶことが大事だった、と書いています。学習目標だけで過信やムラが決まるわけではないので、あくまで同社の仮説として読むのがよいと思います。
使い方の芯は「質問を分解し、判断はコードで」
ここが、この記事でいちばん持ち帰ってほしい部分です。Jevの使い方は、LLMに仕事を丸ごと頼むのとは発想が逆で、判断を小さな質問に分解し、その答えを組み合わせる論理はコードに書くやり方です。公式は「このピッチを評価して」と聞くのではなく、市場規模、技術的な実現性、差別化を別々に聞いて、自分の式で足し合わせろ、と書いています。重み付けを変えたければプロンプトを書き直すのではなく、コードの係数を1つ変えればよい。
公式の評価サイトにある経費精算の例が、その形をよく表しています(金額は日本向けに置き換えています)。社内の規定はこうです。
- すべての申請には領収書が要る。読めなければ再提出を求める
- 経費の種類を判定する(食事、交通、備品)
- 1万円を超える食事は、申請の説明と領収書が明らかに一致していなければ上長の承認が要る
- それ以外は承認
これをJev向けに書き直すと、モデルに聞くのは3つだけになります。領収書は読めるか(Noul)、種類は何か(Choice)、説明と領収書はどれくらい一致しているか(Score、4段階)。そして「1万円超」「明らかに一致していない」「上長へ回す」「承認する」の判断は、全部コードが持ちます。人が書いた規定の各文が、モデルへの質問か、コードの規則のどちらかに割り当てられる形です。
確信度の使い方も、判断を誤ったときの影響に応じて変えます。公式の振り分けの例は音声の銀行操作で、意図の確信度が0.6未満なら一律で人に回す。残高照会なら0.6で実行してよい(間違えても残高を読み上げるだけ)。送金の承認は0.85を超えないと自動では通さず、それ未満なら本人に確認を返す。閾値は1つの数字ではなく、間違えたときの損害の大きさに応じて行為ごとに置く、という設計です。この0.6や0.85は説明用の数字で、本番の閾値は自社のデータで誤判定の割合を測って決めるように、と公式も書いています。
速さが意味を持つのは「次の処理が答えを待つ判断」を全件に挟むとき
(この章は9月17日に書き直しました。当初は書類の仕分け型の用途を並べていましたが、それはJevでなくても済む場面が多いので、速さと安さが要る場面に置き換えています)
公式の用途一覧は、業種別の例のほかに使い方の型を挙げています。処理の流れはコード側で管理し、意味の判断だけをAIに渡して裏で100万回回す「自動化ソフトウェア」。150ミリ秒で人の知覚より速く決める「リアルタイム用途」。LLMの入力・出力・ツール呼び出しのすべてに意味の検査を置く「LLMのガードレール」。ここから考えると、Jevの速さと安さが生きるのは、常に動いているかどうかではなく、次の3つが揃う判断だと思います。その判断が終わるまで次の処理が待たされること、同じ判断が何度も繰り返されること、答えを文章ではなくそのままコードの分岐に使うこと。3つ揃うと、1回の遅れがそのまま全体の遅れになり、1回の費用がそのまま回数分かかります。たとえば検査の時間を仮に5秒と置くと、20回のツール呼び出しに毎回挟めば100秒、同じく仮に0.2秒なら4秒です。
以下は筆者の設計案で、TypeSafeがこの通りの例を出しているわけではありません。
中心に置きたいのは、AIエージェントのすべての操作に置く判断係です。 私たちがAI社員と呼んでいる、手順書と権限を渡して業務を任せるAIは、途中で必ず「この先に進んでよいか」に突き当たります。返信メールを送る直前、フォルダのファイルを消す直前、ブラウザで購入ボタンを押す直前。ここで大事なのは、Jevに「続行か中止か」を丸ごと決めさせないことです。操作の種類(読むだけか、自分の環境を変えるか、外に出るか)と、戻せるかどうかは、ツールの種類と引数と対象からコードで確定できるので、Jevに推測させる必要がありません。外に出る操作と戻せない操作(送信・公開・支払い・削除)は、Jevの答えに関係なく人の承認を待つ。Jevの答えで通してよいのは、戻せる変更と読むだけの操作です。Jevに聞くのは、コードでは判定できない意味の部分だけです。
| 聞くこと | 型 | 答えの形 |
|---|---|---|
| この操作は、渡した手順書が許している範囲か | Noul | 手順書に、この操作を許す記述があるか |
| 送ろうとしている文面に、禁じた表現や約束していない条件、機密が含まれるか | Noul | 含まれるか |
| 手順書との食い違いの大きさ | Score | 0: なし / 1: 解釈の余地がある / 2: 明らかに外れている |
コード側は、戻せる変更は上の答えが閾値内なら通し、読むだけの操作は禁止事項に触れない限り通す、と書く。3つの質問は1回の呼び出しで独立に評価されるので、組み合わせて最終判断を作るのはコードの仕事です。判断の理由は返ってこないので、代わりに確率と入力をそのまま記録に残します。同社測定の70〜500ミリ秒なら、1操作ごとに挟んでも人が待たされる長さにはなりにくく、費用も、同社の評価ワークフローでは既存のLLMより最大444.6倍安く(同社自身が、実運用の差はこれより小さいところに落ち着くと注記しています)、一部ではなく全件の操作に置くことを検討できる価格帯です。実際の遅延と費用は、通信や前後の処理を含めた自社の流れ全体で測る必要があります。
この形は、今週Anthropicが統合した新しいClaudeの「自動」の設計と発想に共通点があります。自動では各ステップの確認を省いて進み、行動の前に自動の安全チェックが走ります。既製品はその検査を中に持っていますが、自社で組んだエージェントには、その部品を自分で置かなければなりません。Jevはその部品の候補です。私たちの記事制作のAI社員は、公開の前に人の承認を挟む手動側の運用ですが、判断係が入れば、人が見る回数を確信の低い操作と戻せない操作に絞りやすくなります。ただし判断係は補助の検査で、間違えることもあるので、権限の制限や許可リスト、戻せない操作の人による承認は、これとは別に残します。
速さを極端に使った公式の例が、毎秒10回で動くゲームのデモです。 発表文の「Fun Demos」に、ゲームのDoomをJevで動かすデモがあります。1秒に10回の問い合わせで、費用は1時間あたり約7ドル。担当したエンジニアは毎秒10回を心配したが、チームの他の面々は「思ったより安い」と受け止めた、とあります。注記も正直で、入力は画像ではなく構造化されたテキストのゲーム状態で(「まだ」と添えてある)、AIを使わない従来のボットのほうが上手にプレイできるが、状態の表現に反応して指示に従うボットが作りたかった、と書いています。もう1つのデモは、Wikipediaのリンクだけをたどって目的のページに着くWikiracingで、1手ごとに数百から数千のリンクから1つを選ぶ、選択肢の多い判断の例です。
エージェントの判断係とDoomは、Jevへの入力と出力の形だけを見れば共通しています。どちらも「その時点の状態をテキストで受け取り、型の決まった小さな判断を1回返す」を繰り返している。違うのは呼ばれるきっかけで、片方は操作のたび、片方は毎秒10回。レジを通るたびに呼ばれる確認係と、時計を見て見回る確認係の違いで、きっかけは違っても確認係がする仕事は同じだ、というのが筆者の整理です。Jevは現場を見続けるのではなく、その都度渡された短い報告書を見て判断する係だと考えると、置き場所を間違えにくくなります。
では、店舗のカメラや工場のラインの監視はどうか。 条件付きで成り立つ、というのが筆者の見立てです。前提として、Jevはテキストしか受け取りません。公式の説明に、画像・音声・動画は非対応で、評価したいなら先に文字にする(音声は書き起こし、画像はキャプション)、とあります。だから店舗のカメラなら、カメラ→人物の検出と追跡→数秒分の動線の集計→テキスト化→Jev→コードで通知、という二段構えになり、Jevに聞くのは「直近の動線は通常の来店の動きと明確に違うか」「この行動の記録は、店舗の規定でいうどの対応区分に当たるか」「混雑の深刻さはどの段階か」のような問いで、区域への立ち入りのように座標で決まることはコードで判定します。工場のラインも同じで、センサーや専用の検査装置が出した数値と検査記録をテキストか構造化したデータにしてから、「この検査記録は欠陥分類Aに当たるか」「欠陥の種類はどれか」を聞き、再検査・隔離・人への通知はコードが決める。どちらも、Jevは一次の検知器ではなく、検出器が上げてきた状態を業務上どう扱うかを決める係です。呼ぶ間隔もゲームのように毎秒10回は要らず、数秒に1回か、異常の候補が出たときだけで足りるでしょう。
逆に、成り立たないものもあります。数十ミリ秒以内の応答が要る機械の制御、人を守るための非常停止、温度や振動の単純な閾値判定。前の2つは応答時間が変動する外部の確率モデルを入れる場所ではなく、最後の1つは普通のコードのほうが確実です。前段の検出器が見落としたものをJevが拾うこともできません。
この設計案の骨組み、つまり質問の型と確信度で分岐する作りは公式の例と同じで、ツール呼び出しの検査とリアルタイム用途は公式の用途一覧に入っています。判断係そのものが間違うこと、「手順書の範囲内か」を聞くには判断に必要な手順書の記述をその都度stateに含める必要があること、日本語での精度が未検証なことは、置く前に確かめる点です。
問い合わせの振り分け、採用書類の一次スクリーニング、LLMが書いた文章の検品のような、机の上に来たものを仕分ける用途も公式の一覧にあり、請求書と発注書の突合は公式の評価ワークフローの1つです。いずれも導入の候補にはなります。ただ筆者は、これらは急ぐ場面が少なく、既存のLLMの構造化出力でも代替しやすいので、Jevを待つ理由は上の例ほど強くない、と見ています。採用のように人の判断に関わる用途では、最終判断を機械に渡さない設計と、応募者への説明責任が別に要ります。
共通するのは、JevはLLMの代わりではなく、LLMとコードの間に置く判断の部品だということです。文章を書く仕事はLLMに残り、判断して分岐する仕事だけをJevが引き受ける。しかも、その判断を「どう聞くか」は導入する側が設計します。
向き不向きを見分ける条件を、公式の説明から4つに絞ると、選択肢や段階を先に定義できること、知識のある人なら数秒で決められること、間違えたときに人に戻せる設計にできること、そして正解が分かる過去データを集められること(確率の当たり具合を自社で確かめるため)です。エージェントの判断係は、操作の記録を人が後から「止めるべきだったか」で判定すれば評価用のデータを作りやすく、店舗や工場の監視は、検出器が出した状態と人が下した判断を対にして残せるかで決まります。
数字の中心は自社評価で、独立した検証は始まったばかり
冷静に見るべき点も書きます。トップページの「193.6倍速い、444.6倍安い」は、TypeSafe自身が作った4つの評価ワークフローから出た数字です。発表文はここに正直で、「実世界の改善幅は、これより低いところに落ち着くと予想する」「参照する正解をGPT-6 AstraとClaude Fable 5.1の平均にしたので、OpenAIとAnthropicのモデルに有利な偏りがある」「価格が補助されていないことは証明できない。長期で持続することで示すしかない」と自分から書いています。公開ベンチマークの成績は意図的に出しておらず、公開ベンチマークを重視せず自分の用途で評価を作れ、という姿勢です。
第三者が触った結果は、発表当日に1つ出ています。米メディアEveryの評価責任者Mike Taylor氏は、自分の記事27本とAI風に書いた10本の計37文書に21問を同時に投げ、0.7秒未満で777件の判断が返り、費用は推定0.25セントだったと書いています。同じ記事で、同社CEOのDan Shipper氏が12の文章にわざと入れた7つの欠陥を、JevとClaude Fable 5.1に探させた比較も載っています。Jevは1件あたり中央値0.35秒、Fableは8.83秒で、Jevが約25倍速く、費用は約580分の1。ただしJevは7件中6件、Fableは7件すべてを見つけた。Taylor氏自身も「本番に入れる前に、もっとちゃんとした精度の確認がほしい」と書いています。安く速い代わりに、1件の見逃しをどう扱うかが問われる、という結果です。
公開当初の利用は早期アクセスの順番待ちでした(9月16日以降の開放は次の章)。対応言語の記載はなく、日本語の判断がどこまで効くかは分かりません。Xでは本人の発表投稿が9月16日朝の時点で1.7万いいねを集めた一方、日本語圏の反応は「面白そう」「第三勢力か」という紹介が数件という段階です。
そのうえで筆者の考えを書きます。「速い判断を安く大量に」という需要は、本人がモデルの名前をJevons(効率が上がると消費が増える、という経済学の法則で知られる人物)から取ったとおり、値段が桁で下がれば桁で増えると思います。先ほどのDoomのデモ(毎秒10回の判断で1時間あたりおよそ7ドル)や、Everyの「全記事を0.7秒で検品」は、業務で言えば「全件を毎回見る」ができる値段です。ただし、それが使えるかどうかは、モデルの賢さより、自社の判断を「知識のある人が数秒で決められる問い」に分解して書けるかにかかっていると思います。経費精算の規定を4行で書けている会社は、Jev向けに書き直せます。規定が担当者の頭の中にしかない会社は、まず規定を書き出すところからで、それはAIの話ではなく業務の話です。
公開から3日で変わったこと 入口が増え、実例が出始めた
(2026年9月18日追記)
発表から3日で、使うまでの距離が縮まりました。TypeSafeは日本時間の9月17日に順番待ちの大半を一斉に開放し、同じ日にVercelのAI Gateway、18日にはCloudflareのAI GatewayとOpenRouter(ベータ)からJevを呼べるようになりました。すでにこれらの中継サービスを使っている会社なら、TypeSafeと直接契約しなくても試せます。CodexやClaude Codeから使うためのスキルもGitHubに公開されていて、リポジトリの手順どおりに導入すれば、エージェントに「TypeSafeのスキルを使って」と頼んで呼び出しのコードを書かせられます。
第三者が作った実例も出てきました。この記事の「流れの途中の判断」の話に、そのまま重なるものが多いです。
- ゲームの操作: 公開当日にSuper Mario BrosをJevに遊ばせた動画が出て、投稿者は「速い推論と型の決まった出力で、リアルタイム用途に驚くほど向く」と書いています。ただし、日本から同じ仕組みで試した人は、元の動画に比べて遅延が2倍以上になり、面をクリアできなかったと報告しています。本人の見立ては「日本からのアクセスが原因で、この用途ではネットワークが足を引っ張る」。日本の読者にとっては、モデルの速さより先に確かめるべき数字です
- モデルの振り分け役: Jevでリクエストごとに最適なモデルを選ぶ振り分け役を作ったという報告。公式の用途一覧にある「モデルルーティング」そのものです
- 配信コメントの仕分け: 日本のエンジニアが、ライブ配信のコメントを「質問・感想・要望・その他」に振り分けるデモを作っています。「アプリやワークフローの小さな判断をAIに任せる使い方に向いてそう」という感想は、この記事の主張と同じです
- 触って試せるデモ: Val Townの遊べるライブデモも公開されています
冷めた見方も出ています。mizchi氏は、TypeSafeと名乗る割にサンプルコードがPythonとJavaScriptしかなく、応答の形も「微妙に型が付いていない」と指摘しています。モデルが答えの候補を絞る話と、SDKの返り値に静的な型が付いているかは別の論点で、後者の観点では製品名や訴求との間に違和感がある、という指摘です。組み込む前にSDKの返り値の形を自分で確かめる価値があります。
この3日で分かったことをまとめると、入口は増え、実例は「速さが要る判断」に集まり、日本からは遅延を先に測る必要がある、の3点です。日本語での判断の精度を測った結果は、確認した範囲ではまだ見つかっていません。(9月21日追記: 自社の問い合わせフォームで日本語の本文を判定させた結果を「Jevを実際に使ってみた」に書きました。合成データ上では、正規の問い合わせと営業・スパムの分離は明瞭でした)
さいごに 文章が要らない判断を、まず3つ探す
「型を守った答え」だけなら、既存のLLMの構造化出力でも出せます。Jevを待つ理由があるとすれば、確率の当たり具合を学習の目標にしていること、質問を並列に評価すること、そして価格と速さの桁です。逆に、判断に理由の文章が要る、日本語で今すぐ使いたい、独立した精度の検証を見てから決めたい、という場合は、既存のLLMで構造化出力を使うほうが今日の時点では現実的だと思います。
すぐ試してみたいなら、入口が増えて待つ理由は減りましたが、それでも先に、自社の業務フローから「文章が要らない判断」を3つ探すところからです。とくに、次の処理が答えを待っていて、何度も繰り返す判断。エージェントの操作が手順書の範囲内か、検出器が上げてきた異常の候補をどう扱うか(この2つは、まず過去の記録で当たり具合を確かめてから置く候補です)、それから問い合わせの振り分けのような仕分け(自社で実装した例)。知識のある人なら数秒で決められる粒度に分解できて、モデルに理由文を書かせる必要はない問いに限ります。ただし、判断に使った規定と入力と出力の記録は残す前提で。見つかったら、その判断の規定を経費精算の例のように数行で書いてみる。書けたなら、Jevでも、既存のLLMの構造化出力でも、試す準備はできています。次に見るのは、残る順番待ちの開放状況、対応言語、そして精度についての第三者の検証がどこまで積み上がるかです。
