Gemini 4 Argon登場 最上位級の性能、ただし今使えるのは防御側の一部だけ

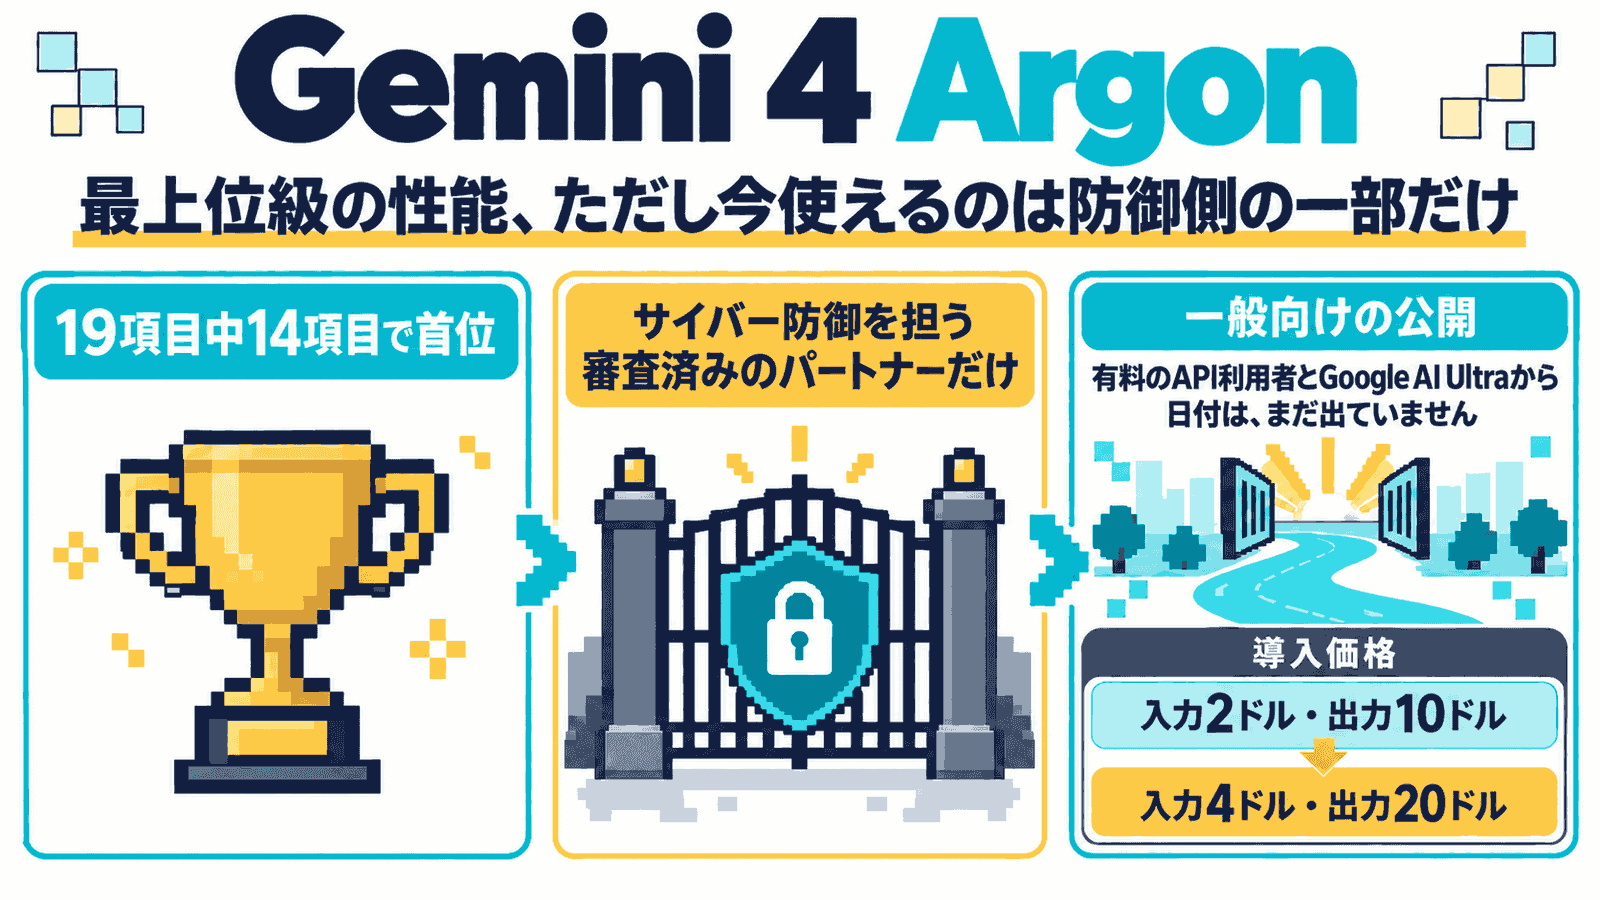
Googleが米国時間9月30日(日本時間10月1日の朝)、新しい最上位モデル「Gemini 4 Argon」を発表しました。長く複雑な仕事をやり切るための深い推論に強いモデルで、公式の比較表では、GPT-6 Astra、Claude Fable 5.1、Claude Opus 5.5を相手に、比較表の19項目のうち14項目で首位(1項目は同率)に立っています。
ただし、一般の開発者や企業、個人は、まだ使えません。 いま使っているのは、Google社内と、サイバー防御を担う一部の審査済みパートナーだけです。一般公開の日付も出ていません。発表の大きさに比べて、手元で試せることがほとんどない。そこが今回いちばん大事な点です。
Argonは、長く深く考える仕事向けの最上位モデル
公式ブログによると、Argonは複雑で長時間にわたる作業の中で、深い推論を続けられるように作られたモデルです。得意分野として挙げられているのは3つ。ソフトウェア開発、法務や財務などの企業の知的な仕事、そしてサイバー防御です。
目立つ変更は、1回で出力できる量の上限です。これまでの6万4,000トークンから、100万トークンに広がりました。何十万トークンも考え、書き続ける余地があることで、難しい問題に一段深く取り組めるようになった、と説明されています。
Google社内では、すでにArgonが使われていて、数千人の社員がその強みを報告しているそうです。エンジニアは、日々のデバッグから大規模なコードの移行まで使っていると書かれています。紹介されている例は規模が大きく、たとえば次のようなものです。
- Argonのエージェントがデータセンター全体の計測データを分析してメモリの使い方を最適化し、300TiBを超えるメモリを空けた(全体では500TiBから1PiBの削減を見込む)
- C/C++で書かれた大きなプログラムを、より安全なRustに書き換える作業を進めている。対象はFuchsiaのZirconカーネルの80万行超まで及ぶ。ただし重要なシステムが多いため、自動と人の両方の監査やテストを経てから本番に移す段階で、80万行がすでに本番で動いているという意味ではない
- 動画のデコーダーのRust版を最適化し、元のRust版より2.7倍速くした
どれもGoogle自身の報告で、かかった計算資源や人の手直しの量までは書かれていません。
いま使えるのは、Google社内とFairwind Programの一部パートナーだけ
社外への提供は、Googleの「Fairwind Program」の一部のパートナーから始まりました。このプログラムは、政府、医療機関、通信事業者など、守りを優先すべき組織に、先端のモデルを早めに使ってもらうための仕組みです。参加には審査があり、Argonを使えるのは、その組織の中のサイバー防御、インシデント対応、侵入テストのチームに限られます。アクセスを他社に回したり売ったりすることも禁じられています。
気になるのは、こうした防御側のパートナーとGoogle社内には、サイバー関連の安全装置を外した状態のArgonを提供していることです。Argonは、ソフトウェアの重大な脆弱性を自分で見つけ、確かめ、修正までできるとされています。その力を守る側に先に渡し、攻撃に使われる前に穴をふさいでもらう、という考え方です。
一般向けの公開は、そのあとです。公式ブログは、一般公開は有料のAPI利用者とGoogle AI Ultraの契約者から始め、開発者、企業、一般の利用者に「できるだけ早く」届けると書いています。これは将来の順番の予定で、いまUltraを契約すれば使えるという意味ではありません。開始日、対象の地域、利用枠はまだ出ておらず、日本での提供時期も示されていません。米国政府の、公開前のモデルを事前に確認する自主的な手続きにも参加しているそうです。
強いサイバー能力を、まず審査した相手だけに渡す、という発想は、Anthropicが9月に、一般向けのFable 5.1とは別に、審査済みの組織向けのMythos 5.1を用意したのと似ています(Fable 5.1の記事)。ただ、Anthropicは一般向けの版を同時に出していたのに対し、Googleはまだ一般向けの版がありません。ここからは筆者の見方ですが、強いサイバー能力を持つ最上位のモデルは、出してすぐ誰でも使える時代ではなくなりつつあると思います。性能と同じくらい、誰に、どの順番で渡すかが問われ始めています。
公式の比較表は、勝った項目より負けた項目と「誰が測ったか」を見る
公式が出した比較表から、主なものを抜き出します。
| 評価 | Argon | GPT-6 Astra | Fable 5.1 | Opus 5.5 |
|---|---|---|---|---|
| 経済価値の高い実務(Vals Index) | 68.9% | 63.1% | 65.8% | 67.0% |
| 業務の自動化(AutomationBench) | 51.3% | 41.4% | 31.4% | 42.5% |
| 財務の調査(Vals Finance Agent v2) | 65.4% | 53.5% | 58.9% | 58.6% |
| 法務の調査と起案(Harvey Legal Agent) | 19.6% | 5.4% | 6.7% | 3.8% |
| 長期のソフトウェア開発(DeepSWE v1.1) | 77.9% | 74.1% | 67.4% | 74.2% |
| 長い文脈のグラフ探索(GraphWalks、25万6千〜100万トークン) | 84.2% | 71.8% | 65.0% | 66.8% |
| ターミナルでのコーディング(Terminal-bench 4.0) | 57.4% | 58.2% | 57.9% | 66.4% |
| 実際のソフトウェア開発(FrontierSWE v2) | 55.0% | 65.5% | 56.3% | 62.3% |
| PC操作(OSWorld-2.0) | 69.2% | 72.6% | ― | ― |
数字を読む前に、2つ注意があります。1つ目は、誰が測ったかが評価ごとに違うことです。評価の条件を見ると、Argonの結果にはGoogle自身が測ったものが含まれ、比較相手の数値も、各社の公表値、公開されている順位表、Googleによる計測が混ざっています。比較相手は原則として最大の思考設定の値です。2つ目は、絶対値です。法務の評価でArgonは2位に約13ポイントの差をつけていますが、その値自体は19.6%で、人の確認を外せる水準ではありません。
そのうえで、差が大きく出たのは、法務の評価、長い文脈のグラフ探索(2位と約12ポイント差)、業務の自動化(約9ポイント差)でした。長い文脈の評価は、契約書を読む試験ではなく、非常に長い入力の中から関係をたどる試験です。法務や財務の資料を扱う仕事に向くかどうかは、この表だけでは言い切れず、実際の文書で試してみないと分かりません。
負けた側も見ておきたいところです。ターミナルでのコーディングはOpus 5.5の66.4%に対して57.4%、実際のソフトウェア開発の評価とPC操作ではGPT-6 Astraに届いていません。ほかに機械学習の実務と科学の評価でも首位を譲っていて、コーディング全般で一番、とまでは言えません。
第三者の評価では、Artificial Analysisの総合指標で、Argon(High設定)は53点でした。GPT-6 AstraやFable 5.1(いずれも最高設定)と同じ点数で、首位はOpus 5.5の最高設定(58点)です。総合指標の評価タスク1件あたりの費用(加重平均)は1.99ドルで、GPT-6 Astraの最高設定(3.26ドル)の約6割でした。
料金は導入価格で入力2ドル・出力10ドル、通常価格に戻ると費用の優位は消えうる
APIの料金は、100万トークンあたり入力2ドル・出力10ドルの導入価格から始まります。キャッシュ済みの入力は、通常の入力の95%引きです。導入期間が終わると、入力4ドル・出力20ドルになります(公式ブログの注記)。導入期間がいつまでかは書かれていません。
この2つの価格は、ちょうど他社の主力モデルの基本単価と重なります。導入価格は、標準のAPIで使う場合のClaude Sonnet 5.5やGPT-6.1 Sol(入力が27万2,000トークン以下の場合)と同じで、通常価格はClaude Opus 5.5の入出力の基本単価と同じです(Claudeの料金表、OpenAIの料金表)。それぞれのモデルについては、Sonnet 5.5の記事とDevDayのまとめで書きました。
ここで、さきほどの「GPT-6 Astraの約6割の費用」を思い出してください。あれは導入価格で計算された数字です。同じトークン量を使い、キャッシュの条件も変わらないと仮定して通常価格に置き換えると、1.99ドルはおよそ3.98ドルになり、GPT-6 Astraの3.26ドルを上回る計算になります。導入期間の安さで選ぶと、期間が終わったときに前提が崩れるかもしれません。 試すときの値段と、使い続けるときの値段は分けて考えたほうがいいと思います。
安全対策は4本柱、指示の乗っ取りには強い結果を示した
公式ブログは、安全対策を4つの柱で説明しています。悪用されそうな依頼への対策、外部の文章に紛れ込ませた指示でAIを乗っ取る攻撃(間接プロンプトインジェクション)への備え、考える過程と行動を監視して必要なら止める仕組み、そして作業を閉じた環境で動かす仕組みの強化です。
数字が示されているのは、2つ目です。Gray Swanの評価で、攻撃を15回試したときの成功率は、Argonが0.7%、Claude Opus 5.5とFable 5.1が1.0%、GPT-6 Astraが8.5%でした(評価の条件)。長時間、自律的に動かすことを前提にしたモデルで、ここに数字を出してきたのは筋が通っていると思います。
ただ、これはこの評価の条件での値で、実際の業務で乗っ取られる確率ではありません。メールやWebページを読ませて仕事をさせるなら、読ませる文章と指示を分ける、渡す権限を絞る、外に出す操作の前に人が確認する、といった備えはこれまでどおり必要です(プロンプトインジェクションの記事)。
最後に いまは待つとき、公開までに評価の材料をそろえておく
Argonは、強いけれど、ほとんどの人はまだ使えないモデルです。中小企業がいますぐやることは、正直ほとんどありません。
私たちも、このブログでは調査と執筆にClaude、画像の生成と原稿の第三者レビューにCodexと、仕事ごとにモデルを分けて使っています。新しいモデルが出るたびに全部を乗り換える必要はなく、仕事ごとに向いたものを当てれば足ります。
もし法務や財務の資料を扱う仕事でArgonを試したいなら、公開を待つ間に、評価の材料をそろえておくと公開後すぐに比べられます。たとえば、試験用に作った架空の文書か、名前だけでなく金額や契約条件など案件を特定できる情報まで除いた代表的な文書を3〜5件、いまのモデルでの結果、そして「どこまでできれば合格か」の基準です。実際の機密文書を入れるのは、データの保持や学習への利用の条件、提供される地域を確かめてからにしてください。法務や財務の判断には、これまでどおり専門家の確認を残すことも前提です。
次に知りたいのは、一般公開がいつ、どの国から始まるのか、そして導入価格がいつまで続くのかです。