Claude Sonnet 5.5登場 Sonnet 5より速く安い、ただしeffortしだい

Anthropicが9月28日(日本時間29日未明)、Claude Sonnet 5.5を発表しました。先週のOpus 5.5に続く、Claude 5.5ファミリーの2つ目のモデルです。公式の説明は「Sonnet 5の明確なアップグレードで、3割以上速く、多くの作業で最大3割安い」。料金の単価はSonnet 5と同じままです。
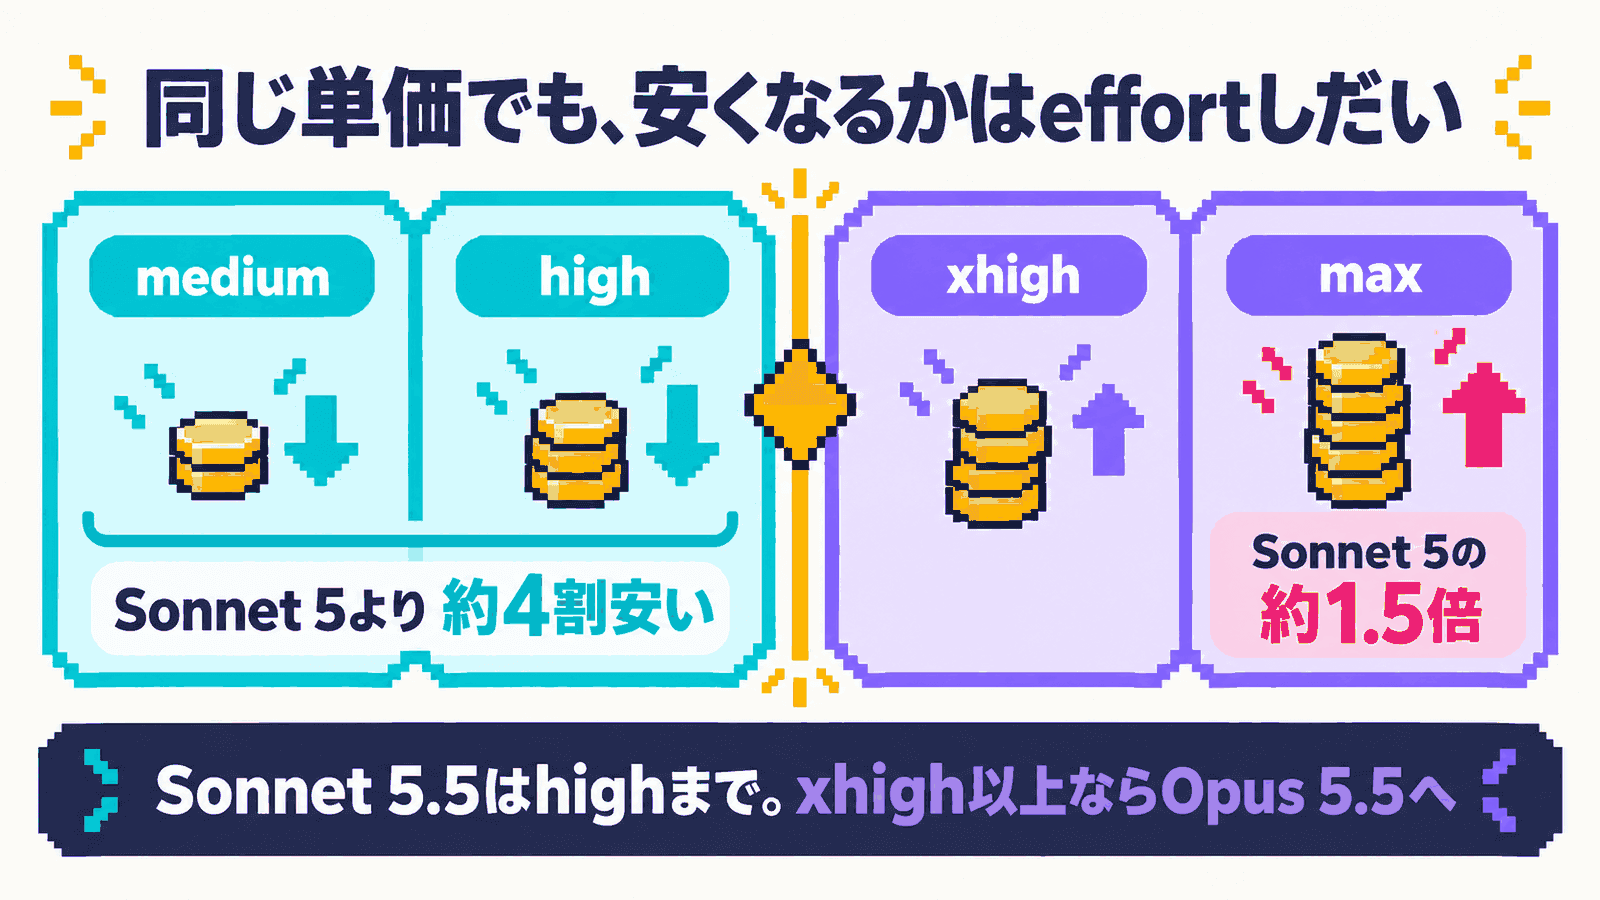
数字を並べてみると、賢さの伸びは想像以上でした。第三者評価のArtificial Analysisの総合点で、Sonnet 5.5は最上位のOpus 5.5にあと2点まで迫っています。一方で、安くなるかどうかは、effort(どれだけ考えさせるかの設定)で大きく変わります。既定のmediumならSonnet 5より約4割安く、最高設定にすると逆に約1.5倍かかります。そしてその分かれ目は、Opus 5.5に替えるタイミングとも重なります。
性能はSonnet 5から大きく伸び、Opus 5.5に迫る
伸び幅がいちばん大きいのは、ターミナルでのコーディングとグラフの読み取りです。公式発表の評価から主なものを並べます。
| 評価 | Sonnet 5.5 | Sonnet 5 | Opus 5.5 |
|---|---|---|---|
| ターミナルでのコーディング(Terminal-Bench 4.0) | 70.6% | 10.3% | 66.4% |
| 実在の職業の実務タスク(GDPval-AA) | 1844 | 1449 | 1846 |
| PC操作(OSWorld 2.1) | 80.1% | 57.0% | 81.8% |
| グラフの読み取り(Chartography) | 61.6% | 15.6% | 64.4% |
| 分野横断の難問(Humanity's Last Exam、ツールあり) | 64.5% | 54.9% | 67.7% |
ターミナルでのコーディングは10%台から70%台へ。グラフの読み取りも4倍近くになりました。実務タスクの評価はOpus 5.5とほぼ同点で、発表文も「44の職業にまたがる実務タスクでOpus 5.5とほぼ並んだ」と書いています(Anthropic公式)。
第三者の評価でも、伸びははっきりしています。Artificial Analysisの総合指標(Intelligence Index)で、Sonnet 5.5は最高設定で56点。Sonnet 5の38点から18点上がり、Opus 5.5(最高設定)の58点に2点差まで迫りました(Artificial Analysis)。最上位モデルのFable 5.1(53点)も上回っています。
弱いところもあります。Artificial Analysisによると、事実知識を問う評価では正答率54%で、Opus 5.5の66%に届きません。公式も、点数では並んでも「長く判断を続けるような、答えの決まっていない複雑な作業では、Opus 5.5がはっきり上」と書いています。点数が近いことと、どんな仕事でも代わりが務まることは別の話です。
単価は据え置き、安くなるかはeffortしだい
料金の単価は、100万トークンあたり入力2ドル、出力10ドル、キャッシュ読み出し0.20ドル。Sonnet 5とまったく同じで、Opus 5.5(入力4ドル・出力20ドル)のちょうど半分です(料金ページ)。単価が同じなのに「最大3割安い」と言えるのは、同じ作業を少ないトークンで終えるようになったからです。
その「少なさ」は、effortによって変わります。Artificial Analysisは、総合指標の評価1問あたりにかかった費用をeffortごとに公開しています。総合指標は10種類の評価を重み付けして平均したものなので、ここでの費用は資料1本やバグ修正1件の料金ではありません。モデルと設定の組み合わせを比べるための目安として見てください。
| effort | Sonnet 5.5 | Sonnet 5 |
|---|---|---|
| medium(アプリとClaude Codeの既定) | 41点・0.59ドル | 28点・1.00ドル |
| high(APIの既定) | 47点・1.08ドル | 32点・1.79ドル |
| 最高設定(max) | 56点・7.60ドル | 38点・5.09ドル |
(点数と評価1問あたりの費用。Sonnet 5.5 medium、high、max、Sonnet 5 medium、high、max)
Sonnet 5の同じ設定と比べると、mediumでもhighでも、点数が上がって費用は約4割下がりました。公式の「最大3割安い」より、むしろ下がっているくらいです。ところが最高設定にすると、Sonnet 5.5は1問あたり約19万3千トークンを出力しました。Artificial Analysisが測った中で最も多く、費用はSonnet 5の約1.5倍です。最高設定での点数の伸びは、大量に考えさせたぶんの費用で手に入れていることになります。
公式の発表文も、この点を隠してはいません。「いくつかの評価では、lowかmediumのSonnet 5.5が、Sonnet 5の最高点を約10分の1の費用で上回る」と書き、Opus 5.5を補うのはeffortを低めにしたときだ、と説明しています。
速さも上がりました。公式は「出力が3割以上速く、これまでで最も速いSonnet」としています。
早く試した企業の声も、トークンの少なさを挙げたものが目立ちます。金融のBalyasny Asset Managementは、2,441件の社内の金融タスクで、1回答あたりのトークンがSonnet 5の約49万7千から約12万1千に減ったと述べています。アプリ生成のBase44は、118件の実際のアプリ作りで、Opus 5と同じ水準の出来を平均3.6回の手直しで出した(Opus 5は7.7回)としています(Anthropic公式)。
Opus 5.5との使い分けは「Sonnetの設定を上げるより、Opusに替える」
xhigh以上が必要な作業なら、Sonnet 5.5の設定を上げるより、Opus 5.5に替えたほうが割安です。
| モデルとeffort | 総合点 | 評価1問あたりの費用 |
|---|---|---|
| Sonnet 5.5 medium | 41 | 0.59ドル |
| Sonnet 5.5 high | 47 | 1.08ドル |
| Opus 5.5 medium | 51 | 1.34ドル |
| Sonnet 5.5 xhigh | 52 | 2.74ドル |
| Opus 5.5 high | 54 | 1.82ドル |
| Sonnet 5.5 max | 56 | 7.60ドル |
| Opus 5.5 max | 58 | 5.98ドル |
(Opus 5.5 medium、high、max、Sonnet 5.5 xhigh)
Sonnet 5.5をxhighまで上げると52点で2.74ドル。Opus 5.5はmediumで51点・1.34ドル、highなら54点・1.82ドルです。この評価では、ほぼ同じ点数をOpusが約半額で出し、最高設定どうしでもOpusのほうが点数が高く、費用は安くなりました。単価は倍でも、Artificial Analysisの計測ではOpus 5.5のほうが出力トークンが少なく済んでいました。
Xでも、似た結論にたどり着いた使い手がいます。開発者のKieran Klaassen氏は、「Sonnet 5.5はOpus 5.5の延長のようで、多くの点で品質が近く、ずっと安くて速い」としたうえで、「素早く繰り返す作業、とくにデザインや試作に使い、effortはlowかmediumで。highやxhighが要る作業ならOpusに移す」と書いています。この評価の数字ではhighまでは割安なので、線を引く位置は筆者の見立てのほうが一段上です。
ここまでの数字から、筆者の考える使い分けはこうです。
- Sonnet 5.5(lowからhigh): 範囲のはっきりした日常の作業。バグ修正、資料やスライドの作成、試作の繰り返し、裏で回す定型処理
- Opus 5.5(mediumかhigh): Sonnet 5.5のhighで足りないとき。xhighに上げる前に、モデルを替える
- Fable 5.1: 難しい推論や長時間の自律作業(次の章)
公式のモデル一覧も、迷ったらまずOpus 5.5から始めるよう勧めています(公式ドキュメント)。Sonnet 5.5は「日常のコーディング、エージェント、企業の業務に向けた速さと能力」という位置づけです(公式ドキュメント)。
OpenAIのGPT-6 Solとは、この評価でほぼ横並びです。Solの単価は入力2ドル・出力10ドルでSonnet 5.5と同じで(GPT-6 Sol・Lunaの記事)、Solの最高設定が48点・1.06ドル、Sonnet 5.5のhighが47点・1.08ドルとほぼ横並びでした(GPT-6 Sol)。この程度の差なら、乗り換えの理由にはならないと思います。すでに使っているほうで、Sonnet 5.5と同じ使い分けをすれば足ります。
Fable 5.1は、難しい推論と長い自律作業に絞る
最上位のFable 5.1は、単価が入力10ドル・出力50ドルで、Sonnet 5.5の5倍です。Artificial Analysisの総合点では、Fable 5.1(最高設定)が53点・7.63ドル。Sonnet 5.5の最高設定(56点・7.60ドル)が、ほぼ同じ費用で上回りました(Fable 5.1)。
それでもFable 5.1の出番がなくなったわけではありません。公式のモデル一覧は、Fable 5.1を「難しい推論と長時間の自律作業のため」のモデルと説明しています(公式ドキュメント)。総合点は幅広い問題の平均なので、長い作業を途中で投げ出さずにやり切る力や、一部の難題での粘り強さまでは表しません。何時間も自律で動かす作業や、途中の判断を1つ誤ると手戻りが大きい作業では、最初からFable 5.1を候補に入れてよいと思います。
プランでの扱いはFable 5と同じです。Maxでは週の上限の半分までを追加料金なしでFableに使え、Proでは定額の枠に含まれず、使った分だけの従量課金になります(Claude公式ヘルプ)。
| 使いどころ | モデル | 単価(入力/出力、100万トークンあたり) |
|---|---|---|
| 日常の作業、繰り返し | Sonnet 5.5(low〜high) | 2ドル / 10ドル |
| Sonnetで足りないとき | Opus 5.5(medium〜high) | 4ドル / 20ドル |
| 難しい推論、長時間の自律作業 | Fable 5.1 | 10ドル / 50ドル |
なお、ここで使ったArtificial Analysisの評価は、公開前の版で行われています。Anthropicによると、その版には構造化出力を使うリクエストの回答を損なうバグがあり、公開時には修正済みです。影響は小さく、点数はやや低めに出ているとみられています(Artificial Analysisは再計測する予定)。
乗り換えで気をつけること
アプリとClaude Code。 Anthropicは、Sonnet 5.5をAWS、Google Cloud、Microsoft Azureを含むすべてのプラットフォームで提供すると発表しています。実際に選べるかは、プランや組織の設定、使っているツールのバージョンによります。Claudeのアプリの料金ページのプラン表では、Free・Pro・Maxのどれでも「Sonnet」が使えるとされています(料金ページ)。Claude Codeは、ClaudeのプランやAnthropic APIで設定を変えていなければ、既定モデルはOpus 5.5のままです。変わったのは「sonnet」と指定したときの行き先で、Anthropic APIではSonnet 5.5になり(Claude Code 2.1.284以降)、そのときの既定のeffortはmediumです(Claude Codeのドキュメント)。
安全装置で、Sonnet 5に切り替わることがある。 Sonnet 5.5はサイバーセキュリティの能力が大きく上がったため、Sonnetとして初めて、リスクの高いサイバー関連の依頼をSonnet 5に切り替える仕組みが入りました。公式は、普段のソフトウェア開発には影響しないとしています。ただ、判定は最新のメッセージだけでなく、メモリや読み込んだファイル、Web検索の結果まで見て行われるので、自分で打っていない内容がきっかけで切り替わることもあり得ます。アプリでは、切り替わったあと、そのチャットはSonnet 5のまま続きます(Claude公式ヘルプ)。Artificial Analysisの評価では、切り替わったのは全体の約0.1%でした。
APIで使っている場合。 思考(thinking)をオフにして使っていた人は、そのままだとエラーになります。Sonnet 5.5では完全にオフにはできず、最初にまとめて考える部分だけを止める between_tools という設定に変える必要があります。ツール呼び出しの強制(tool_choice)が使えなくなるなど、ほかにも互換性のない変更があるので、切り替える前に移行ガイドを読んでおくと安心です。
Sonnet 5はすぐには終わりません。提供終了は早くても2027年6月30日とされています(公式ドキュメント)。残るHaiku 5.5は「数週間以内」の予定です。
最後に まずmediumで回し、足りなければOpusへ
Sonnet 5.5は、Sonnet 5で「賢さが物足りない」「思ったより高くつく」と感じていた人ほど、試す価値があるモデルです。ただし、Artificial Analysisの評価で見る限り、安さを受け取れるのはhighまでで、xhigh以上が必要ならOpus 5.5に替えたほうが割安です。自社の作業でも同じになるかは、下の試し方で確かめてみてください。
私たちも、簡単なコーディング作業からSonnet 5.5に切り替えて、品質を見てみるつもりです。
すぐ試すなら、ふだんの業務から代表的な作業を3〜5件選び、Sonnet 5.5のmediumとOpus 5.5のmediumで同じ依頼を出して、出来と使用量を比べてみてください。1件だけだと偶然の差が大きいので、数件で見るのがおすすめです。Sonnetで満足できればそのまま、足りなければeffortを上げる前にOpusへ。次に見ておきたいのは、Artificial Analysisの再計測の結果と、数週間以内に出るHaiku 5.5の料金です。