Claude Haiku 5.5登場 単価はHaiku 4.5の1割、ただし10万トークンが境目

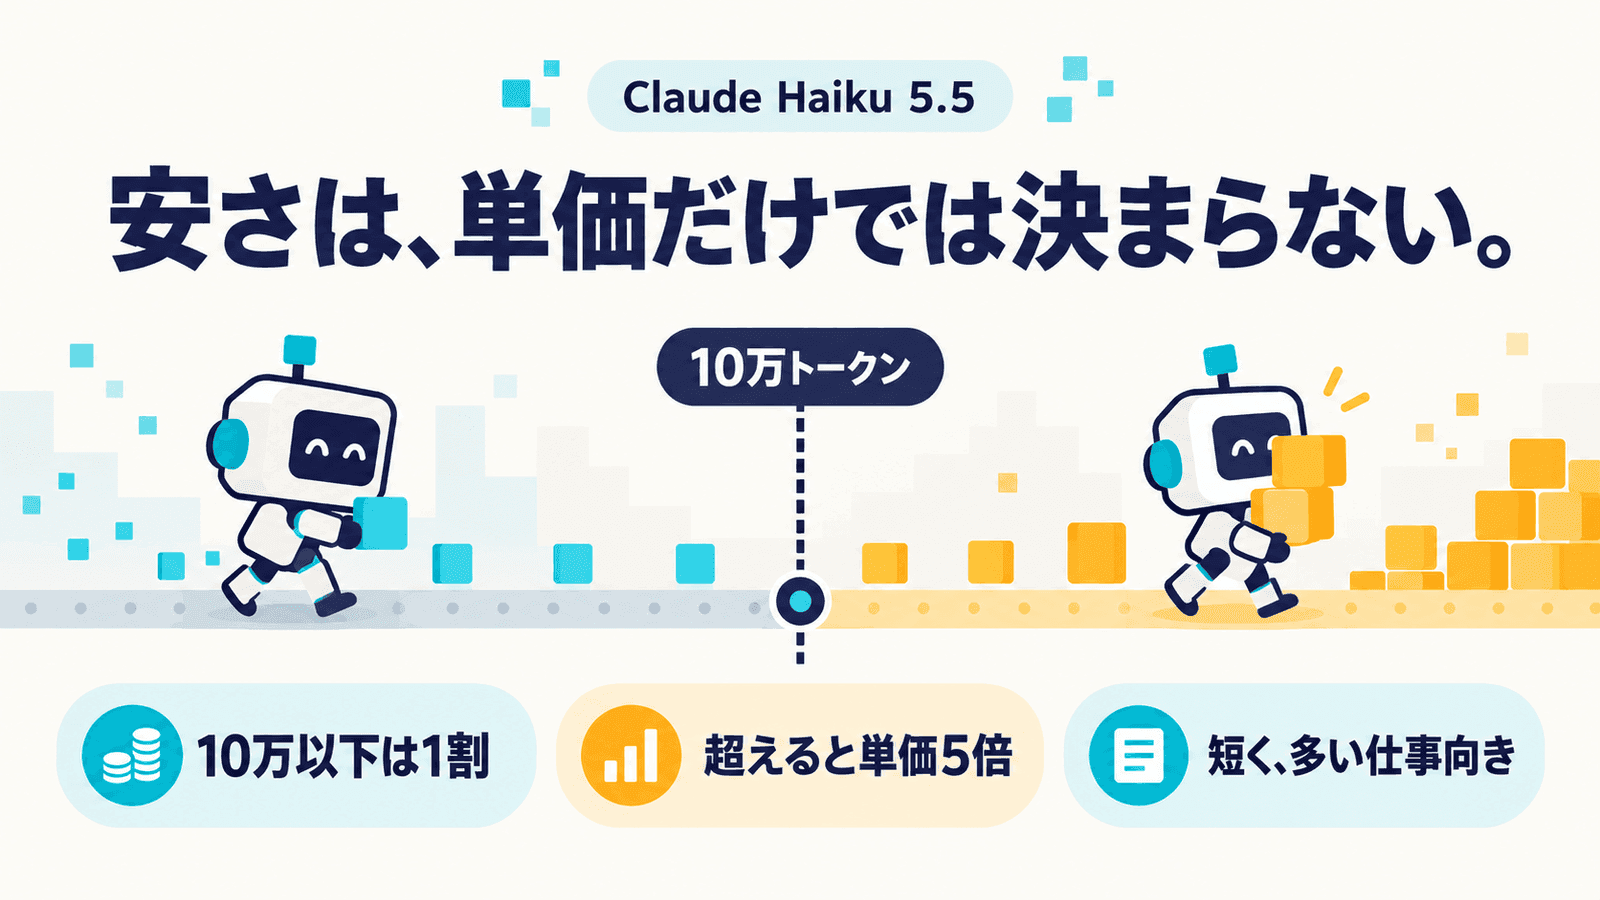
Anthropicが日本時間10月8日の未明、新しい小型モデル「Claude Haiku 5.5」を公開しました。公式の触れ込みは「これまでで最も安く、最も速く、最も賢い小型モデル」。Haiku 4.5と比べて、平均で約75%安く動くとしています。
同じ発表では、Sonnet 5.5のキャッシュ読み出しの値下げと、MaxとTeamのプランに毎月のAPIクレジットを付けることも告知されました(クレジットについては別の記事にまとめています)。
小型モデルとしては、性能も値段も確かに大きく動きました。ただ、「1割の単価」がそのまま請求額になるわけではありません。単価が5倍になる境目があり、外部の評価では、仕事をこなすのに使うトークンも多めでした。
小型の競合を上回るが、Sonnet 5.5との差はまだ大きい
公式が出したベンチマークから、主なものを抜き出します。比較相手は、前のHaiku 4.5、OpenAIの小型モデルGPT-6 Luna、参考としてSonnet 5.5です。
| 評価 | Haiku 5.5 | Haiku 4.5 | GPT-6 Luna | Sonnet 5.5 |
|---|---|---|---|---|
| GDPval-AA v2.1(知的な業務) | 1620 | 735 | 1437 | 1840 |
| OSWorld 2.1(コンピューターの操作) | 72.4% | 15.7% | 48.9% | 83.9% |
| Terminal-Bench 4.0(コマンド操作を伴う開発) | 39.2% | 0.0% | 16.4% | 70.6% |
| Humanity's Last Exam(ツールなし) | 45.9% | 10.2% | — | 56.9% |
(出典は公式の発表。OSWorldはオフラインの一部の課題での値)
Haiku 4.5からの伸びは大きく、とくにコンピューターの操作とコマンド操作の数字は別物です。ただ、どの評価でもSonnet 5.5には届いていません。
外部の評価機関Artificial Analysisも、公開当日に結果を出しています。総合指数は、最も高いeffort(推論にかける手間の設定)で43点。前のHaikuから26点上がり、小型のGemini 3.8 Flash(41点)やGPT-6 Luna(38点)をわずかに上回りました。一方、Sonnet 5.5の最高設定は56点で、13点の差があります。
もう1つの変化は、Haikuで初めてeffortを選べるようになったことです。公式ドキュメントでは既定がmediumで、コンテキストは100万トークン、出力は最大12万8,000トークンです。
単価は1割、ただし10万トークンを超えると5倍になる
料金は、プロンプトの長さで2段になりました。1回のリクエストのプロンプトが10万トークンを超えると、そのリクエストは入力も出力もキャッシュも高いほうの単価になります(公式の料金表)。
| 100万トークンあたり | Haiku 5.5(10万トークン以下 / 超) | Haiku 4.5 | Sonnet 5.5 |
|---|---|---|---|
| 入力 | 0.10ドル / 0.50ドル | 1.00ドル | 2.00ドル |
| 出力 | 0.50ドル / 2.50ドル | 5.00ドル | 10.00ドル |
| キャッシュ読み出し | 0.01ドル / 0.05ドル | 0.10ドル | 0.10ドル |
10万トークン以下ならHaiku 4.5の1割、超えると5倍に上がって5割です。公式の注記によると、Haiku 4.5へのリクエストの9割は10万トークン以下でした。「平均で約75%安い」は、この割合と、トークンの数え方の変化を織り込んだ数字です。公式ドキュメントによると、Haiku 5.5では同じ文章がHaiku 4.5より約30%多いトークンとして数えられます。
加えて、仕事をこなすのに使うトークンの量も見ておきたいところです。Artificial Analysisによると、Haiku 5.5は最高設定で、評価の課題1つあたり約16万2,000の出力トークンを使いました。GPT-6 Lunaの約3倍です。同じくらいの点数で比べても、Haiku 5.5はLunaより多くのトークンを使うとしています。10万トークン以下の単価はLunaと同じなので、使うトークンが多いぶん、同じ仕事でも請求はHaikuのほうが高くなりえます。Xでも、同じ3Dの場面を作らせたらHaikuのほうが12倍かかったという比較が出ています(1つの作業での比較です)。
なお、この16万2,000は課題1つで出力したトークンの合計で、料金の段を決める「1回のプロンプトの長さ」とは別の量です。Artificial Analysisのサイトはまだ2段の料金を反映できておらず、高いほうの単価を含まない暫定の費用を出しているそうです。単価表だけで「Lunaと同じ値段」と判断せず、自分の仕事で実際に使ったトークンで比べるのが安全だと思います。
Sonnet 5.5にも値下げがあります。キャッシュ読み出しが、100万トークンあたり0.20ドルから0.10ドルに半額になりました。キャッシュの読み出しが多いエージェント的な作業では、Sonnet 5.5が全体で約2割安くなるとしています。
effortは、xhighあたりが使いどころ
Artificial Analysisは、effortごとの点数と、評価の課題1つあたりの費用も分けて公開しています(2026年10月8日時点)。
| effort | 総合点 | 課題1つあたりの費用 |
|---|---|---|
| low | 29 | 0.02ドル |
| medium(既定) | 34 | 0.05ドル |
| high | 38 | 0.08ドル |
| xhigh | 41 | 0.12ドル |
| max | 43 | 0.21ドル |
| 参考: GPT-6 Luna(max) | 38 | 0.07ドル |
| 参考: Sonnet 5.5(medium) | 41 | 0.48ドル |
総合点は10種類の評価を重み付けして平均したもので、費用も資料1本や問い合わせ1件の料金ではありません。モデルと設定を比べるための目安として見てください。Haikuの費用は、プロンプトが10万トークンを超えたときの高い単価を含まない暫定の値です。
並べてみると、使い分けの目安が見えてきます。
- low・medium: 分類や抜き出しのように、答えの形が決まった短い仕事。足りるなら一番安い
- high: GPT-6 Lunaの最高設定と同じ38点で、費用もほぼ同じ。Lunaと比べるならここから
- xhigh: Sonnet 5.5のmedium(アプリとClaude Codeの既定)と同じ41点を、約4分の1の費用で出している
- max: xhighから2点上がるだけで、使うトークンは約1.8倍(Artificial Analysisの説明)。費用は2倍近くになる
筆者は、費用と点数のつり合いで見ると、xhighあたりが使いどころだと思っています。これまでSonnet 5.5をmediumで回していた仕事のうち、要約や調べものの下作業は、Haiku 5.5をxhighに上げて置き換えられるかもしれません。ただ、総合点が同じでも、評価ごとの得意不得意は違います。置き換えるなら、まず自分の仕事で質を確かめてからです。
向いているのは、短くて数の多い仕事
公式が挙げている用途は、要約、会話の圧縮、データベースへの問い合わせ、分類のような、大量で費用に敏感な仕事です。Opus 5.5やSonnet 5.5のもとで動くサブエージェント(大きなモデルの指示で下作業をこなす役)にも向くとしています。標準の速度で比べればAnthropicで最も速いモデルでもあるので(高速モードのOpusよりは遅い)、ライブのカスタマーサポートやブラウザの操作のように、待ち時間が気になる用途にも合うそうです。
逆に、公式自身が、複雑なエージェント型のコーディングではSonnet 5.5とOpus 5.5のほうが良いと書いています。先ほどのTerminal-Benchの差(39.2%と70.6%)を見ても、そこはまだ大きいモデルの仕事です。
先行して試した企業の声もあります。HubSpotはCRMの課題を集めた評価で、これまで試した小型モデルで最高の92.8%だったそうです。AlphaSenseは、週に約800万回呼んでいる文書への質問応答で、Haiku 4.5の0.76から0.84に上がったとしています。後者は、まさに短い仕事を大量に回す場面です。
安全面では、サイバーセキュリティの制限がHaiku 4.5より厳しくなりました。防御側の作業はSonnet 5.5より広く通る一方、侵入テストのような攻撃側に使われやすい作業は止めるとしています。
Claude CodeやAPIで使うなら、圧縮を10万トークンの手前に
Claude Codeでは、モデルの指定で haiku を使っていると、AnthropicのAPI経由ならHaiku 5.5に切り替わります。公式ドキュメントによると、Claude Codeは v2.1.293 以降が必要です。Amazon Bedrock、Google Cloud、Microsoft Foundry経由では、haiku はまだHaiku 4.5を指します。
APIキーの従量課金でClaude Codeを使っている人には、Xで紹介された設定が役に立ちます。Lydia Hallie氏の投稿によると、Haikuを選んだ状態で /autocompact 100k と打つと、Haiku 5.5の会話が10万トークンに近づいたところで自動で圧縮され、安い価格帯に収まりやすくなります。この設定はモデルごとに保存されるので、サブエージェントを含むHaikuだけに効きます。
自分のアプリからAPIで呼ぶ場合も、考え方は同じです。Claude APIには、入力トークンが決めた量に達したら、古いやり取りをサーバー側で要約に置き換える「しきい値での圧縮」(ベータ)があり、Haiku 5.5でも使えます。長い会話やエージェントの作業でHaiku 5.5を使うなら、そのしきい値を10万トークンより手前に置いておくと、安い価格帯に収めやすくなります。ただし、要約を作る処理の分も課金されます。費用を測るときは、レスポンスの通常のトークン数だけでなく、圧縮の処理分(usage.iterations)も足して計算します。MaxやProのプランの利用枠の中だけで使っているなら、トークンごとの請求はないので、料金の段は直接は関係しません。ただし、利用枠を超えたあとの追加利用を有効にしている場合は、APIの単価で請求されます。
Haiku 4.5は当面使えます。提供終了の予定表では、Haiku 4.5は「有効」のままで、廃止の告知も出ていません。表にある2026年10月15日は、そこまでは提供を続けるという最低限の期限で、その日に終わるという意味ではありません。とはいえ、公開からほぼ1年がたつので、移行の準備は始めておいてよい時期です。
安いモデルの選び方が「単価」から「使ったトークン」に変わる
ここまでが公式とArtificial Analysisの数字です。ここからは筆者の見方です。
私たちは9月に、問い合わせフォームの営業メールの振り分けを、TypeSafe AIのJevで組みました。その記事では、同じ判定を普通のLLMにやらせたらいくらかの机上の試算を置き、Haiku 4.5でも1件0.42円で、Jevの約30倍としていました。同じ前提(入力2,069トークン、出力150トークン、当時の記事と同じ為替)でHaiku 5.5を計算し直すと、1件約0.04円です。同じ文章が約30%多く数えられる分を足しても約0.05円で、Jevの0.013円との差は約4倍まで縮まります。既定のmediumで考えるときに使うトークンは入っていない机上の数字ですが、同じ条件で並べる限り、差は1桁小さくなりました。
こうなると、小さなモデルを選ぶときの物差しが変わると思います。安さは、単価だけでは決まりません。Haiku 5.5とGPT-6 Lunaは、10万トークン以下の単価が同じです。通常の処理で費用の差を大きく左右するのは、同じ質の結果を出すまでにどれだけトークンを使うかと、プロンプトが10万トークンの境目を超えるかどうかです。私たちの問い合わせの振り分けのように、1件が短く、件数が多い仕事なら、境目はまず超えません。残るのは使うトークンの差で、これは単価表からは読めません。何件か実際に流して、請求で比べるしかないと思います。
この見方が当たっているかは、Artificial Analysisが2段の料金を反映した「課題1つあたりの費用」を出したときに見えてくると思います。そこでHaikuとLunaの差がどれだけ開くかが、1つの目安です。
最後に 自分の仕事を10件流して、トークンを数える
すぐ試すなら、次の3つです。
- いまHaiku 4.5やGPT-6 Lunaで回している仕事を10件選ぶ: 要約、分類、抜き出しのような、短くて数の多いもの
- Haiku 5.5の既定(medium)とxhighで流し、入力と出力のトークン数を記録する: プロンプトが10万トークンを超えていないかも見る。長い会話になるなら、圧縮の設定を10万トークンの手前にしておく
- 1件あたりの費用と結果の質を、今のモデルと並べる: 単価ではなく、実際にかかった額で比べる
MaxかTeamのプランを使っていて、今回始まった毎月のAPIクレジットをConsoleの組織で受け取っていれば、この比較を追加の支払いなしで試せます。