Gemini 3.8 Flash TTSとは 文章で声を作り、自分の声も複製できる

Googleが音声合成の新しいモデル「Gemini 3.8 Flash TTS」と「Gemini 3.8 Flash-Lite TTS」を正式に公開しました。Gemini APIの変更履歴では9月22日付で一般提供となり、日本時間の9月24日未明にXで発表されています。TTSは「Text to Speech」の略で、文章を読み上げる音声を作るAIのことです。
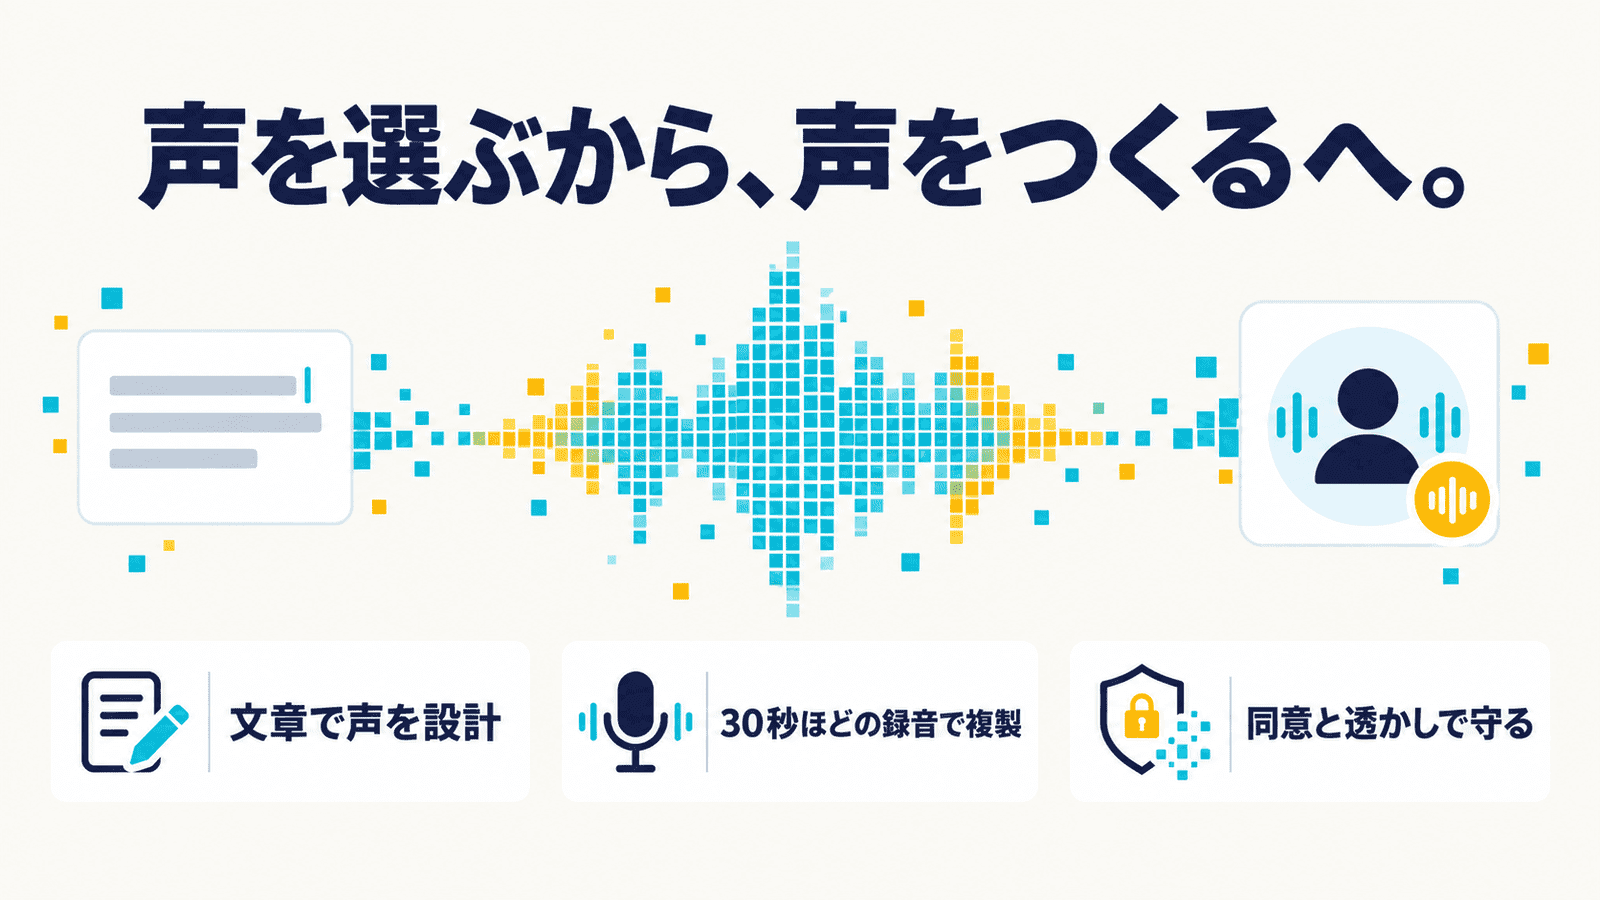
これまでの読み上げAIは、用意された何十種類かの声から選んで、書いた文章を読ませるものでした。今回のモデルは違います。「60代の、穏やかで温かい声の男性」と文章で書くと、その声を作ってくれます。さらに、自分の声を30秒ほど録音すれば、その声で好きな文章をしゃべらせることもできます。読み上げるAIから、声そのものを作って演技までさせるAIに変わった、という発表です。
便利な反面、声の複製は悪用されれば詐欺にも使えます。Googleが複製にどんな確認の仕組みを入れたのか、費用はいくらか、会社で使うなら何を決めておくべきかまで、公式の資料を確かめながら見ていきます。
声の選び方は4通り、既製・ライブラリ・文章で作る・複製する
公式の文書によると、声の用意の仕方は4つあります。
| 方法 | 中身 | 向く場面 |
|---|---|---|
| 既製の声 | 厳選された30種類。「明るい」「落ち着いた」などの性格付き | まず試す、社内向けの読み上げ |
| 声のライブラリ | 言語・なまり・用途(ニュース、朗読など)で絞り込める大量の声 | 目的に合う声を探す |
| 文章で作る(Voice design) | 年齢、声質、なまりを文章で説明して、新しい声を作る | 自社キャラクター、ブランドの声 |
| 実在の声を複製(Voice replication) | 本人の録音から、その人の声を再現する | 自分の声でのナレーション、講師の声での教材 |
ライブラリの数は、発表では「2,000以上」、APIの文書では「数百」と書かれていて、資料によって数え方がそろっていません。いずれにしても、30種類から選ぶしかなかった前の世代とは桁が違います。
モデルは2つで、使い分けははっきりしています。
- Flash TTS: 表現力を優先したモデル。朗読、2人の掛け合い、方言、細かい演技の指示に強く、130の言語に対応
- Flash-Lite TTS: 量と速さを優先したモデル。大量の読み上げ、電話の自動応答、声の複製を日常的に使う場面向けで、101の言語に対応
日本語はどちらも対応しています。Googleは、人が聞き比べて選ぶ評価で、日本語などの主要言語で上位に入ったと説明しています。
文章で声を作るときは「変わらない特徴」と「その場の演技」を分ける
声を作る手順は単純です。Google AI Studioの音声の画面で、作りたい声を説明する文章を書くと、声が作られて試聴用の音声が返ってきます。気に入ったら保存すると voice_... から始まるIDが付き、以後はそのIDを指定するだけで同じ声を呼び出せます。
コツは、公式の文書に書かれている次の分け方です。
- 声を作るときに決めるもの: 年齢、性別、声質、なまりなど、その人物がずっと変わらない特徴
- 読ませるたびに指示するもの: 「ささやき声で急いで」「明るく元気に」など、その場の感情や話し方
たとえば社内研修の講師役なら、声を作る段階で「40代の女性、落ち着いた明るい声、標準語、聞き取りやすいはっきりした話し方」と決めておきます。そのうえで、注意事項を読む場面だけ「真剣に、少しゆっくり」と指示する。性格を毎回書き直すと声がぶれるので、変わらない部分は声の側に固めておくわけです。説明は1〜2文で具体的に書くほうが、長い段落より安定するとされています。
演技の指示は細かくできます。文の途中に <sigh>(ため息)、<laugh>(笑い)、<short pause>(短い間)のようなタグを入れると、その位置で息づかいや間が入ります。日本語の文章でも、タグは英語のまま書くのが推奨です。2人の会話なら、聞き手の「うんうん」「へえ」のような相づちを話し手の台詞の途中に重ねることもできます。
作った声は、1つのプロジェクトに200個まで保存でき、保存期間は1年です。同じ説明文から作り直しても、まったく同じ声になる保証はありません。長く使うブランドの声にするなら、期限が来たときにどうするかを、使い始める前に確かめておくべきです。
声の複製には、同じ話者による同意の録音が要る
実在の人の声を複製する機能には、Googleが確認の仕組みを入れています。ただし、身分証で本人を確かめるような「本人確認」ではありません。公式の文書によると、複製には同じ大人の話者による2本の録音が必要です。
- 見本の音声: 複製したい声で自然に話した、10〜30秒の録音
- 同意の音声: 同じ人が、決められた同意文を読み上げた録音
日本語の同意文は、次のとおりです。
私はこの音声の所有者であり、Googleがこの音声を使用して音声合成モデルを作成することを承認します。
Googleのシステムは、見本と同意の録音が同じ話者のものかを照合します。見本の録音だけでは複製の手続きに進めず、同じ人が同意文を読んだ録音をあわせて出す必要がある、という作りです。照合を通しやすくするため、2本は同じマイク、同じ部屋で録るよう勧められています。
そのほかの安全策も、発表で説明されています。
- Googleの音声モデルで作った音声には、すべてSynthIDという聞き取れない透かしが入り、AIが作った音声だと後から判別できる
- 複製した声には、来歴を示すC2PAの情報も付く
- 複製した声の特徴のデータを、Google側に残さない方式も選べる。この場合は暗号化された鍵を自社で持ち、鍵は7日で使えなくなる
ただし、どこでも使えるわけではありません。AI Studioでの声の複製は、米国のイリノイ州とテキサス州、EEA(EU加盟国などの欧州経済領域)、英国、スイス、インドでは使えません。理由は発表には書かれていません。発表時点で、日本は使えない地域に挙がっていません。
とはいえ、確かめられるのは「見本と同じ話者が同意文を読んだ」ことまでです。上司に頼まれて読んだのか、どんな用途に使われると理解して読んだのかまでは、システムには分かりません。この点は後の章で触れます。
費用は音声1時間で約130円、2027年からは倍
料金ページでは、音声は1秒あたり25トークンとして数えます。出力する音声の料金は次のとおりです(1ドル160円で換算)。
| モデル | 2026年12月31日まで | 2027年1月1日から |
|---|---|---|
| Flash TTS | 音声1時間 約0.81ドル(約130円) | 約1.62ドル(約260円) |
| Flash-Lite TTS | 音声1時間 約0.54ドル(約86円) | 約1.08ドル(約173円) |
読ませる文章(入力)にも料金がかかりますが、音声に比べれば小さな額です。急がない処理をまとめて頼む「Batch」なら、音声の料金はさらに半額になります。
身近な量に置き換えると、こうなります。
- 10分の研修ナレーションを1本: Flashで約22円
- 30秒の案内音声を月100本: Flash-Liteで約72円
- 3時間のオーディオブック: Flashで約390円
年内は導入価格で、2027年から倍になる点は、長く使う前提で予算を組むなら押さえておきたいところです。
無料枠もあります。AI StudioやAPIの無料枠で試す分には費用はかかりませんが、無料枠で送った内容は、Googleの製品改善に使われます。有料で使えば改善には使われません。
ただし、声の複製は無料枠では使えません。AI Studioで複製を始めようとすると、支払い情報を設定したプロジェクトの有料のAPIキーをつなぐよう案内されます。料金はGoogle AI Proのような月額のプランではなく、上の表の単価によるAPIの従量課金です。結果として、複製のために送る自分や社員の声の録音は、製品改善には使われない枠で扱われることになります。
使える場所は、開発者向けと一般向けで違う
いま使えるのは、次の場所です。
- 開発者向け: Gemini APIと、Google AI Studio(ブラウザで声を作り、試聴し、2人の台本を編集できる画面がある)
- 一般向け: Flash TTSはGemini Notebook(旧NotebookLM)に、Flash-Lite TTSはGoogleの動画作成ツールGoogle Vidsに組み込まれる
- 企業向け: Gemini Enterpriseからは「近日提供」
APIで使う場合、電話回線で使われる音声形式(μ-law、A-law)でも出力できるので、電話の自動応答にも組み込みやすい仕様です。なお、相手の声を聞きながらリアルタイムに会話する用途は、別のモデルであるGemini 3.8 Liveの領域です。
業務に入れるなら、声の「持ち主」を先に決める
ここまでが公式の資料で確かめた事実です。ここからは、業務で使う立場からの筆者の考えになります。
すぐに効きそうな使い道は、次のあたりだと思います。
- 研修やマニュアルの音声化: 文字のマニュアルを、決まった講師の声のナレーションにする。更新のたびに録り直さなくて済む
- 動画のナレーション: 採用動画や商品説明の動画で、ナレーターを手配せずに試作する
- 多言語の案内: 英語や中国語の案内を作る。同じ声でどこまで自然に話せるかは、言語ごとに試して確かめる
- 電話の一次応答: 営業時間外の案内や、よくある問い合わせへの受け答え
私たちも、AIで作ったものを社内外に見せる場面が増えていますが、音声は文章や画像よりも「誰の声か」が強く伝わります。だからこそ、技術より先に決めておくべきことがあると考えています。
- 社員の声を使うなら、会社と社員の間で取り決める。同意文の録音は、声の持ち主としてGoogleに合成音声の作成を認める、というものです。会社と社員の間の取り決めではありません。書面で同意をもらうのは出発点にすぎず、少なくとも次を決めておくべきだと思います
- 誰がその声を作り、誰が使ってよいか
- 何に使うか、途中で用途を広げるときはどうするか
- 本人が同意を取り消したい、または退職したときに、保存した声と作った音声をどうするか。消すなら誰が確かめるか
- 他人の声は使わない。取引先や有名人の声に似せた声を文章で作ることも、トラブルのもとです。実在の人に似せるかどうかは、社内ルールで線を引いておくのが無難です。声の権利(パブリシティ権など)や労務の扱いは、実際に使う前に専門家に確認してください
- AIの声だと分かるようにする。電話の自動応答や動画では、相手が人の声だと思い込まないよう、「AIの音声です」と最初に伝える運用にしておくのがよいと思います
AIの社内ルールを作っている会社は、音声の項目を足すタイミングだと思います。
最後に
声の複製に同意文の録音を必須にし、生成した音声には透かしを入れる。この設計は正しいと思います。少なくとも、他人の声を勝手に複製するハードルは上がりました。
ただ、社内で声を使い始めると、保存期間が1年で切れること、退職した人の声が残ること、誰が作ったか分からない声が増えることのほうが、先に問題になるのではないでしょうか。声も、画像やロゴと同じ会社の資産として台帳で管理し、期限や持ち主の変化を定期的に見直す。そこまでやって、初めて業務に入れられるのだと思います。
すぐ試すなら、まずAI Studioで既製の声を聞き比べてみてください。自分の声を登録せずに、無料枠で試せます。次に見ておきたいのは、Gemini Enterpriseでの提供がいつ始まるかと、声を後から調整できる「Voice remixing」(近日提供と予告)がどこまでできるかです。